
Trang thông số chip laptop của Intel ghi sức mạnh NPU theo đơn vị TOPS, kèm nhãn INT8 ngay bên cạnh. Hiểu đơn giản, đây là kiểu số nguyên 8 bit: mỗi giá trị chỉ chiếm 1 byte và nhận một trong 256 mức từ -128 đến 127, thay vì số có phần thập phân như FP16 (số dấu phẩy động 16 bit). Kiểu số gọn này giúp NPU nhân cộng nhanh hơn và đọc ít dữ liệu hơn, đổi lại mô hình phải qua bước lượng tử hóa và chấp nhận một mức sai số nhất định.
INT8 là gì và vì sao NPU ưu tiên số nguyên 8 bit
Về bản chất, một mô hình AI là tập hợp hàng triệu tới hàng tỷ tham số. Mỗi tham số là một con số được nhân với dữ liệu đầu vào rồi cộng dồn vào kết quả. Phép nhân cộng này, gọi tắt là MAC, chiếm phần lớn khối lượng tính toán khi mô hình suy luận. Khi tham số được lưu ở dạng số nguyên 8 bit, mạch nhân chỉ phải xử lý 8 bit thay vì 16 hoặc 32 bit, nên kích thước nhỏ hơn, tiêu thụ ít điện năng hơn và cùng một diện tích chip chứa được nhiều bộ MAC hơn.
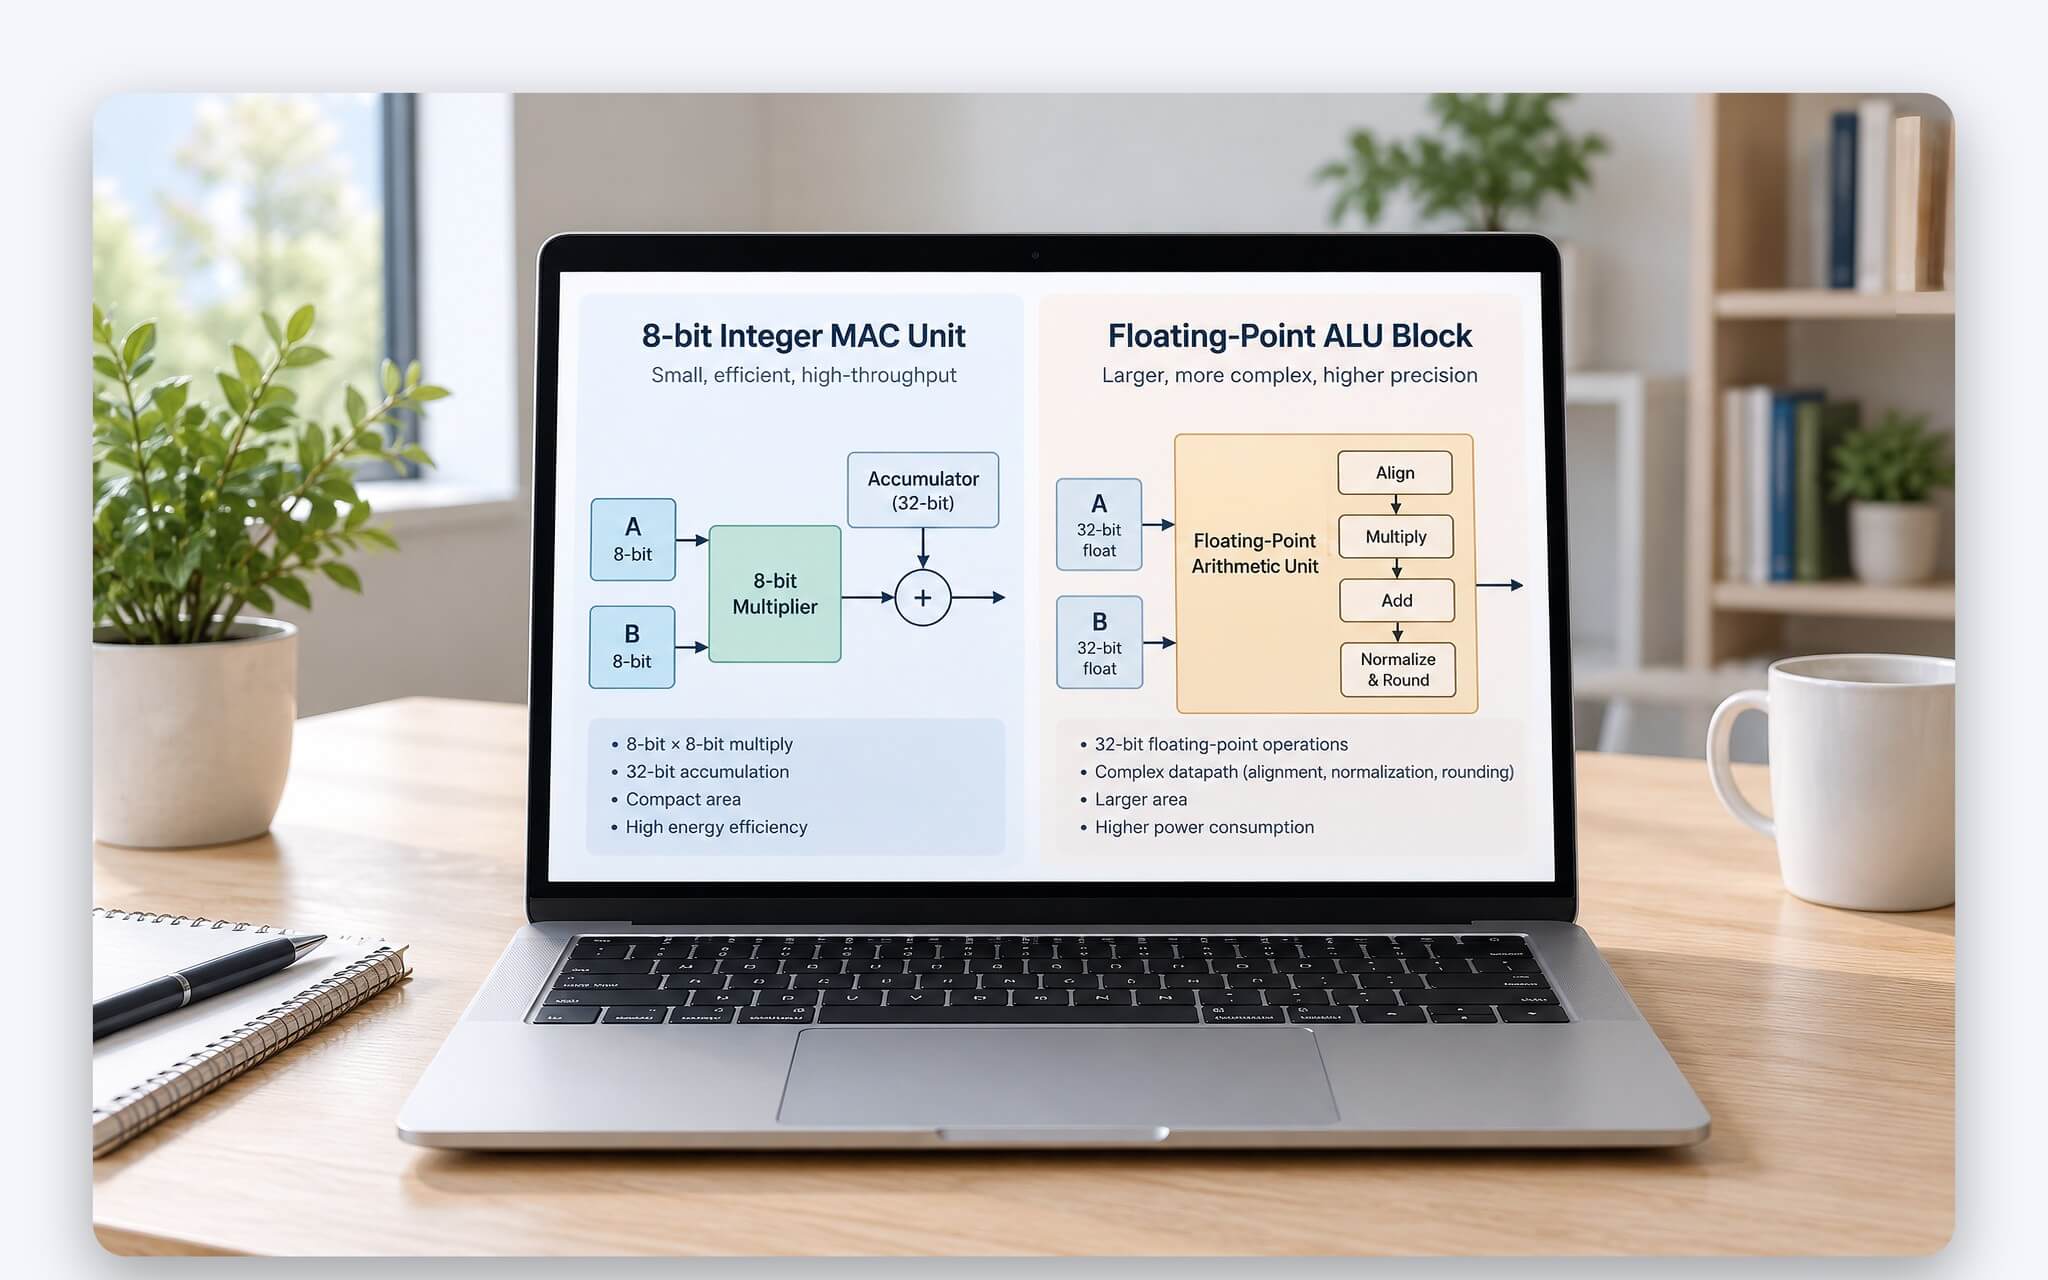
Đó là lý do NPU trên laptop được thiết kế xoay quanh mạch số nguyên. Theo datasheet dòng Intel Core Ultra 200V, NPU của dòng chip này gồm 6 khối Neural Compute Engine, mỗi khối có 2.048 bộ MAC 8 bit, tổng cộng 12.288 bộ MAC cùng 9 MB bộ nhớ đặt sát khối tính toán. Tài liệu cũng liệt kê ba kiểu dữ liệu được hỗ trợ khi suy luận là INT4, INT8 và FP16, nghĩa là NPU không chỉ làm việc với số nguyên mà vẫn xử lý được số dấu phẩy động.
Ưu thế thứ hai nằm ở dung lượng. Một tham số dạng số nguyên 8 bit chiếm 1 byte, bằng một nửa so với 2 byte của định dạng 16 bit. Với mô hình 4 GB ở dạng 16 bit, phần trọng số về lý thuyết chỉ còn khoảng 2 GB sau khi chuyển đổi, chưa tính hệ số tỷ lệ và những lớp phải giữ độ chính xác cao. Dữ liệu ít đi thì băng thông RAM, vốn thường là điểm nghẽn của tác vụ AI trên laptop, cũng được giải phóng tương ứng.
FP16 khác INT8 ở cấu trúc bit và dải giá trị
FP16 là số dấu phẩy động nửa độ chính xác theo chuẩn IEEE 754, gồm 1 bit dấu, 5 bit số mũ và 10 bit định trị. Nhờ phần số mũ, định dạng này biểu diễn được cả giá trị rất nhỏ lẫn giá trị lớn tới 65.504, đồng thời giữ được phần thập phân. Kiểu số nguyên thì không có số mũ, chỉ có 256 nấc cách đều nhau, nên muốn mô tả một số thực phải dựa vào hệ số tỷ lệ đi kèm.
| Tiêu chí | INT8 | FP16 |
|---|---|---|
| Loại số | Số nguyên có dấu | Số dấu phẩy động theo chuẩn IEEE 754 |
| Cấu trúc bit | 8 bit giá trị, không có số mũ | 1 bit dấu, 5 bit số mũ, 10 bit định trị |
| Dung lượng mỗi giá trị | 1 byte | 2 byte |
| Miền biểu diễn | -128 đến 127 (256 mức cách đều) | Khoảng -65.504 đến 65.504, có phần thập phân |
| Vai trò phổ biến | Suy luận trên mô hình đã lượng tử hóa | Mô hình gốc, tinh chỉnh, lớp nhạy cảm về sai số |
Khác biệt cấu trúc dẫn tới cách phản ứng khác nhau khi gặp giá trị bất thường. Ở định dạng dấu phẩy động, một trọng số lớn gấp trăm lần mức trung bình vẫn được ghi nhận khá sát nhờ số mũ tự co giãn. Ở định dạng 8 bit, toàn bộ dải giá trị phải nén vào 256 nấc, nên chỉ một giá trị ngoại lai lớn cũng kéo giãn hệ số tỷ lệ, khiến các giá trị nhỏ bị gộp chung vào cùng một nấc và độ phân giải giảm rõ rệt.
Vì vậy hai định dạng không nằm trong quan hệ hơn kém tuyệt đối. Số dấu phẩy động an toàn về độ chính xác nhưng tốn gấp đôi bộ nhớ và cần mạch tính toán phức tạp hơn. INT8 nhanh và gọn nhưng đòi hỏi bước chuyển đổi cẩn thận, kèm dữ liệu hiệu chỉnh để chọn hệ số tỷ lệ hợp lý cho từng lớp. Nhiều mô hình triển khai trên NPU dùng cả hai, lớp nào chịu được sai số thì chạy số nguyên, lớp nào nhạy cảm thì duy trì dấu phẩy động.
Lượng tử hóa đưa mô hình từ FP16 về INT8 như thế nào
Lượng tử hóa là quá trình ánh xạ mỗi giá trị số thực vào một nấc số nguyên. Theo tài liệu lượng tử hóa của ONNX Runtime, giá trị thực bằng hệ số tỷ lệ nhân với hiệu giữa giá trị lượng tử và điểm không (zero point). Hệ số tỷ lệ quyết định mỗi nấc ứng với bao nhiêu đơn vị thực, còn điểm không bảo đảm giá trị 0 được biểu diễn chính xác, điều kiện quan trọng với các lớp có phần đệm bằng số 0.
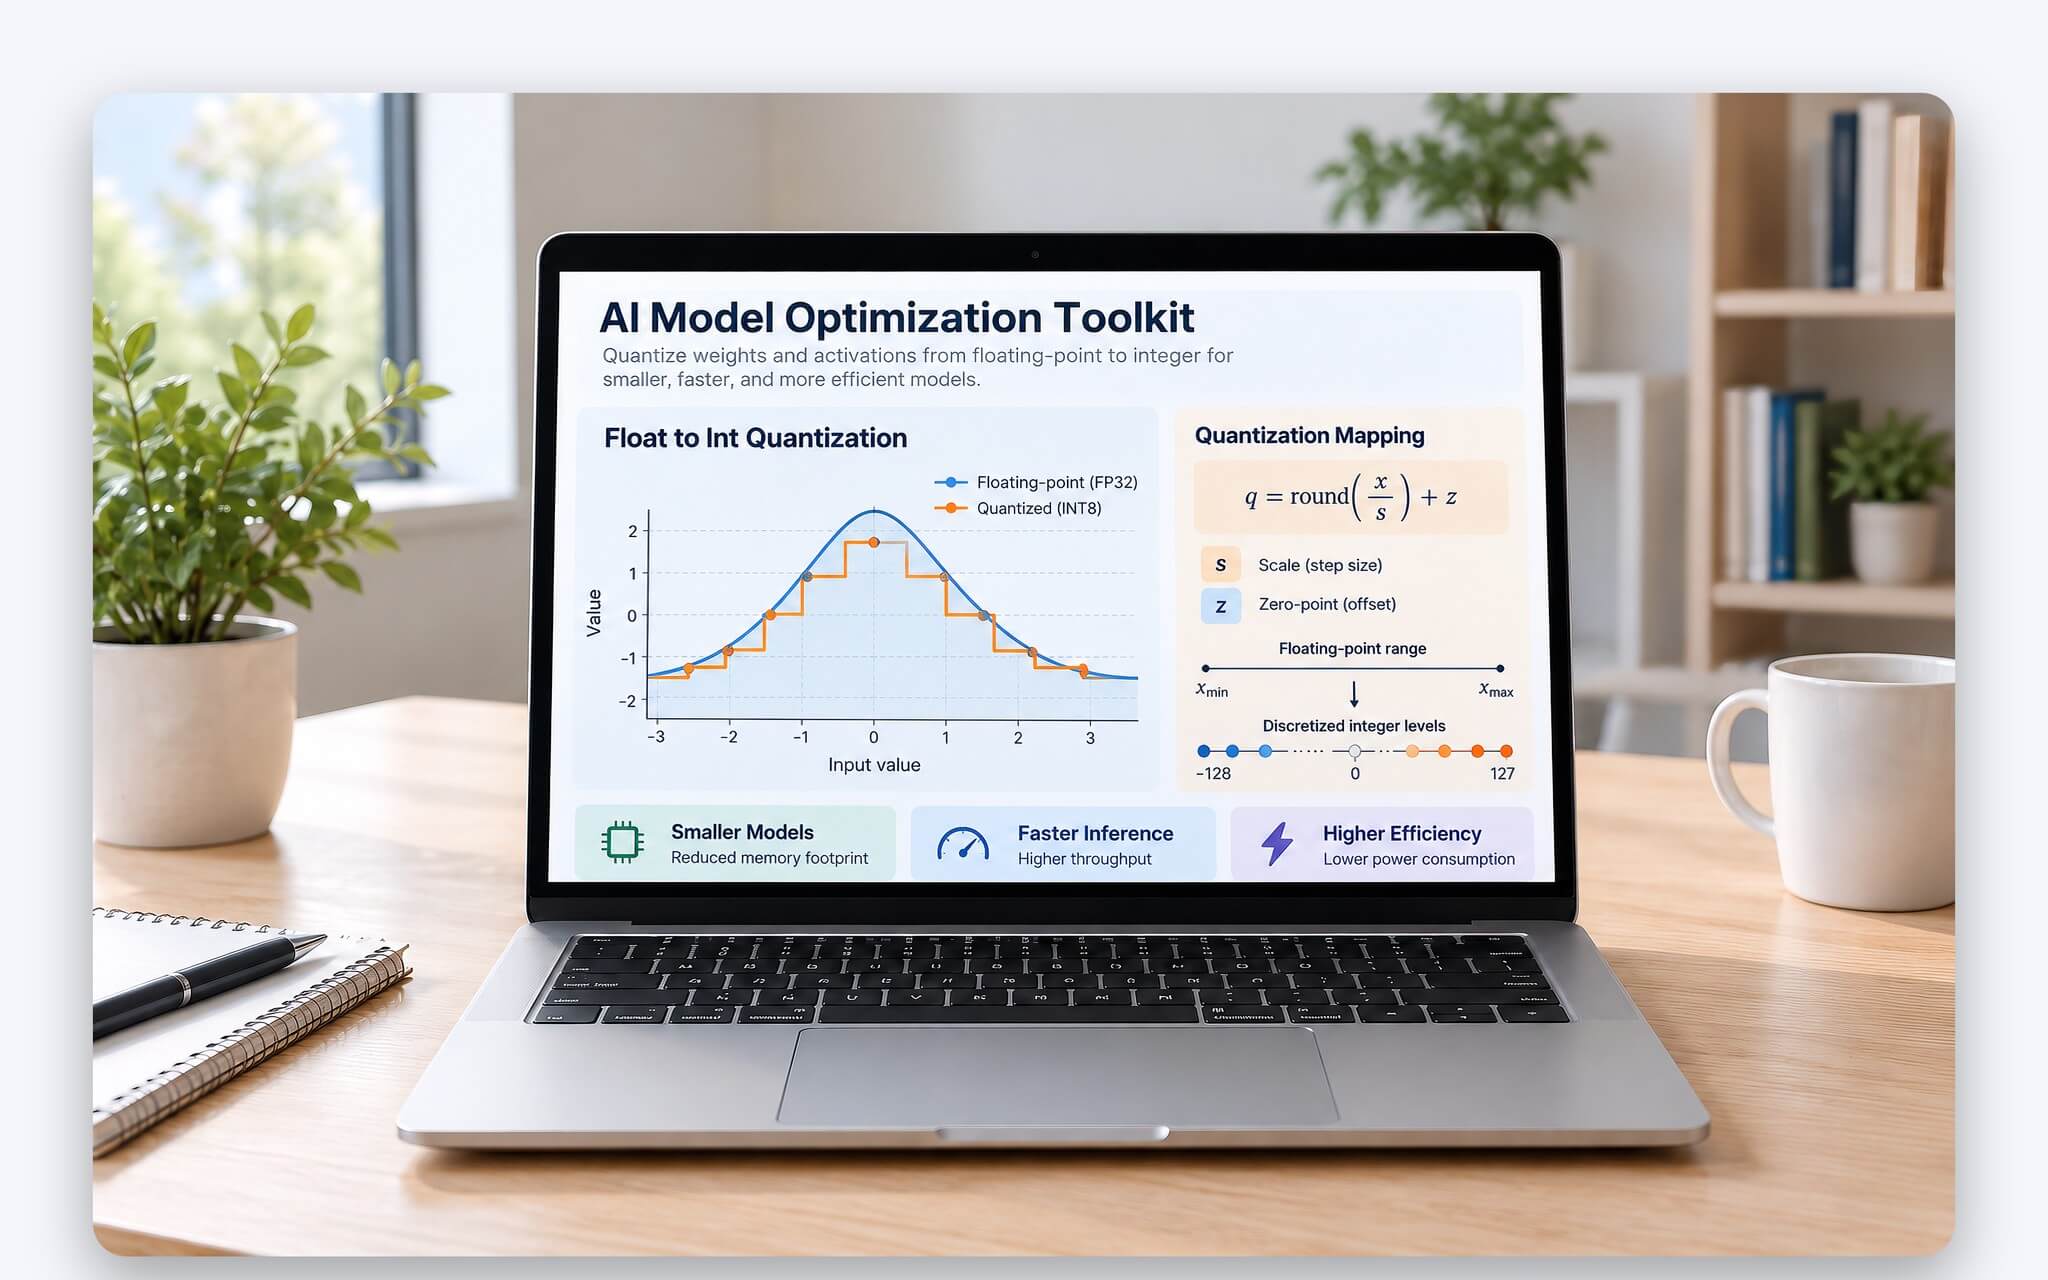
Có hai cách xác định hệ số tỷ lệ cho giá trị kích hoạt. Lượng tử hóa động tính hệ số ngay khi mô hình chạy, dựa trên dữ liệu thực tế của từng lượt suy luận. Lượng tử hóa tĩnh cho mô hình chạy thử với một tập dữ liệu hiệu chỉnh, ghi lại phân bố giá trị rồi cố định hệ số. ONNX Runtime hỗ trợ ba phương pháp hiệu chỉnh là MinMax, Entropy và Percentile, mỗi phương pháp xử lý giá trị ngoại lai theo nguyên lý riêng.
Hướng thứ ba là huấn luyện có nhận thức lượng tử hóa (QAT), mô phỏng sai số của số nguyên 8 bit ngay trong lúc huấn luyện để mô hình tự thích nghi. Phương án này thường đáp ứng yêu cầu chất lượng tốt hơn lượng tử hóa sau huấn luyện (PTQ) nhưng tốn thêm thời gian và tài nguyên. Với mô hình ngôn ngữ chạy cục bộ, cộng đồng còn dùng các định dạng 4 bit chia khối riêng, và bài Quantization Q4: Cấu trúc quyết định Q4_K_M hơn Q4_K_S như thế nào? phân tích cấu trúc của nhóm định dạng này.
Độ chính xác giảm bao nhiêu khi mô hình chạy INT8
Mức suy giảm độ chính xác không có con số cố định, vì phụ thuộc kiến trúc mạng, phân bố trọng số và chất lượng dữ liệu hiệu chỉnh. Tài liệu ONNX Runtime nêu rõ lượng tử hóa không phải phép biến đổi bảo toàn thông tin và có thể làm giảm độ chính xác của mô hình. Các mạng thị giác máy tính như phân loại ảnh hay nhận diện vật thể thường chịu được việc chuyển đổi khá tốt, trong khi mô hình ngôn ngữ lớn nhạy hơn do có nhiều giá trị kích hoạt ngoại lai.
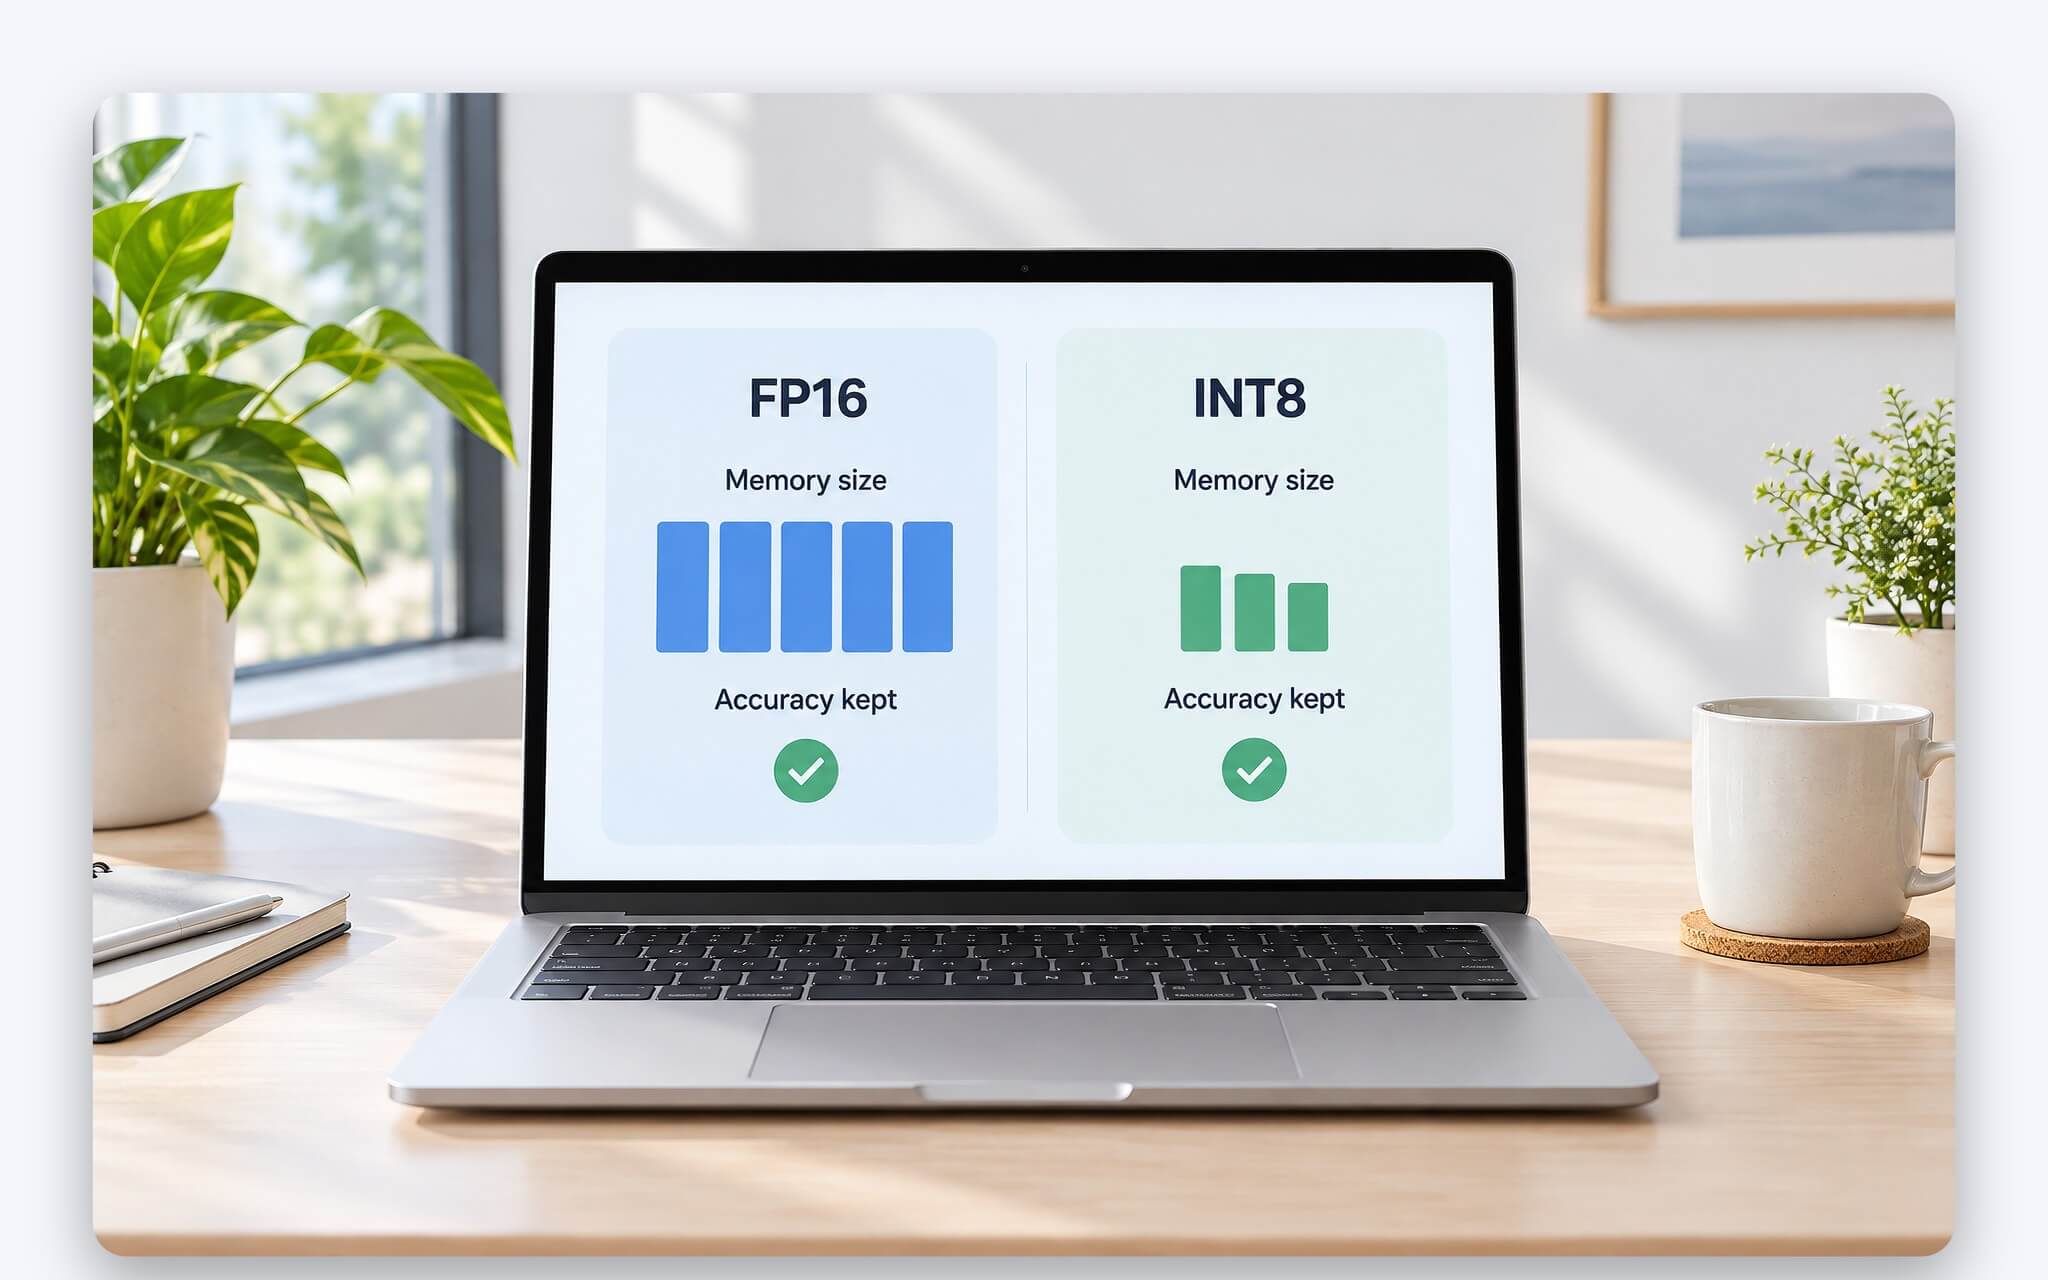
Giải pháp phổ biến là độ chính xác hỗn hợp. Bộ công cụ chỉ lượng tử hóa những lớp chịu được sai số, còn lớp đầu, lớp cuối hoặc lớp chuẩn hóa vẫn giữ FP16. NVIDIA TensorRT cũng tách riêng từng kiểu dữ liệu lượng tử như INT8, INT4 chỉ áp cho trọng số và FP8, cho thấy mỗi phần của mô hình có thể dùng một định dạng khác nhau. Sau chuyển đổi, mô hình luôn cần được xác minh lại trên tập kiểm thử trước khi đưa vào ứng dụng.
Huấn luyện là giới hạn rõ nhất của số nguyên 8 bit. Quá trình lan truyền ngược tạo ra gradient có độ lớn chênh lệch rất xa, nhiều giá trị nhỏ tới mức bị làm tròn về 0 nếu chỉ có 256 nấc. Vì thế huấn luyện và tinh chỉnh vẫn dựa vào FP16, BF16 hoặc FP32. Datasheet của Intel cũng mô tả NPU nhắm tới các ứng dụng suy luận học sâu (inferencing), chứ không giới thiệu khối này cho việc huấn luyện.
TOPS hãng công bố tính ở INT8 nên không so thẳng với FP16
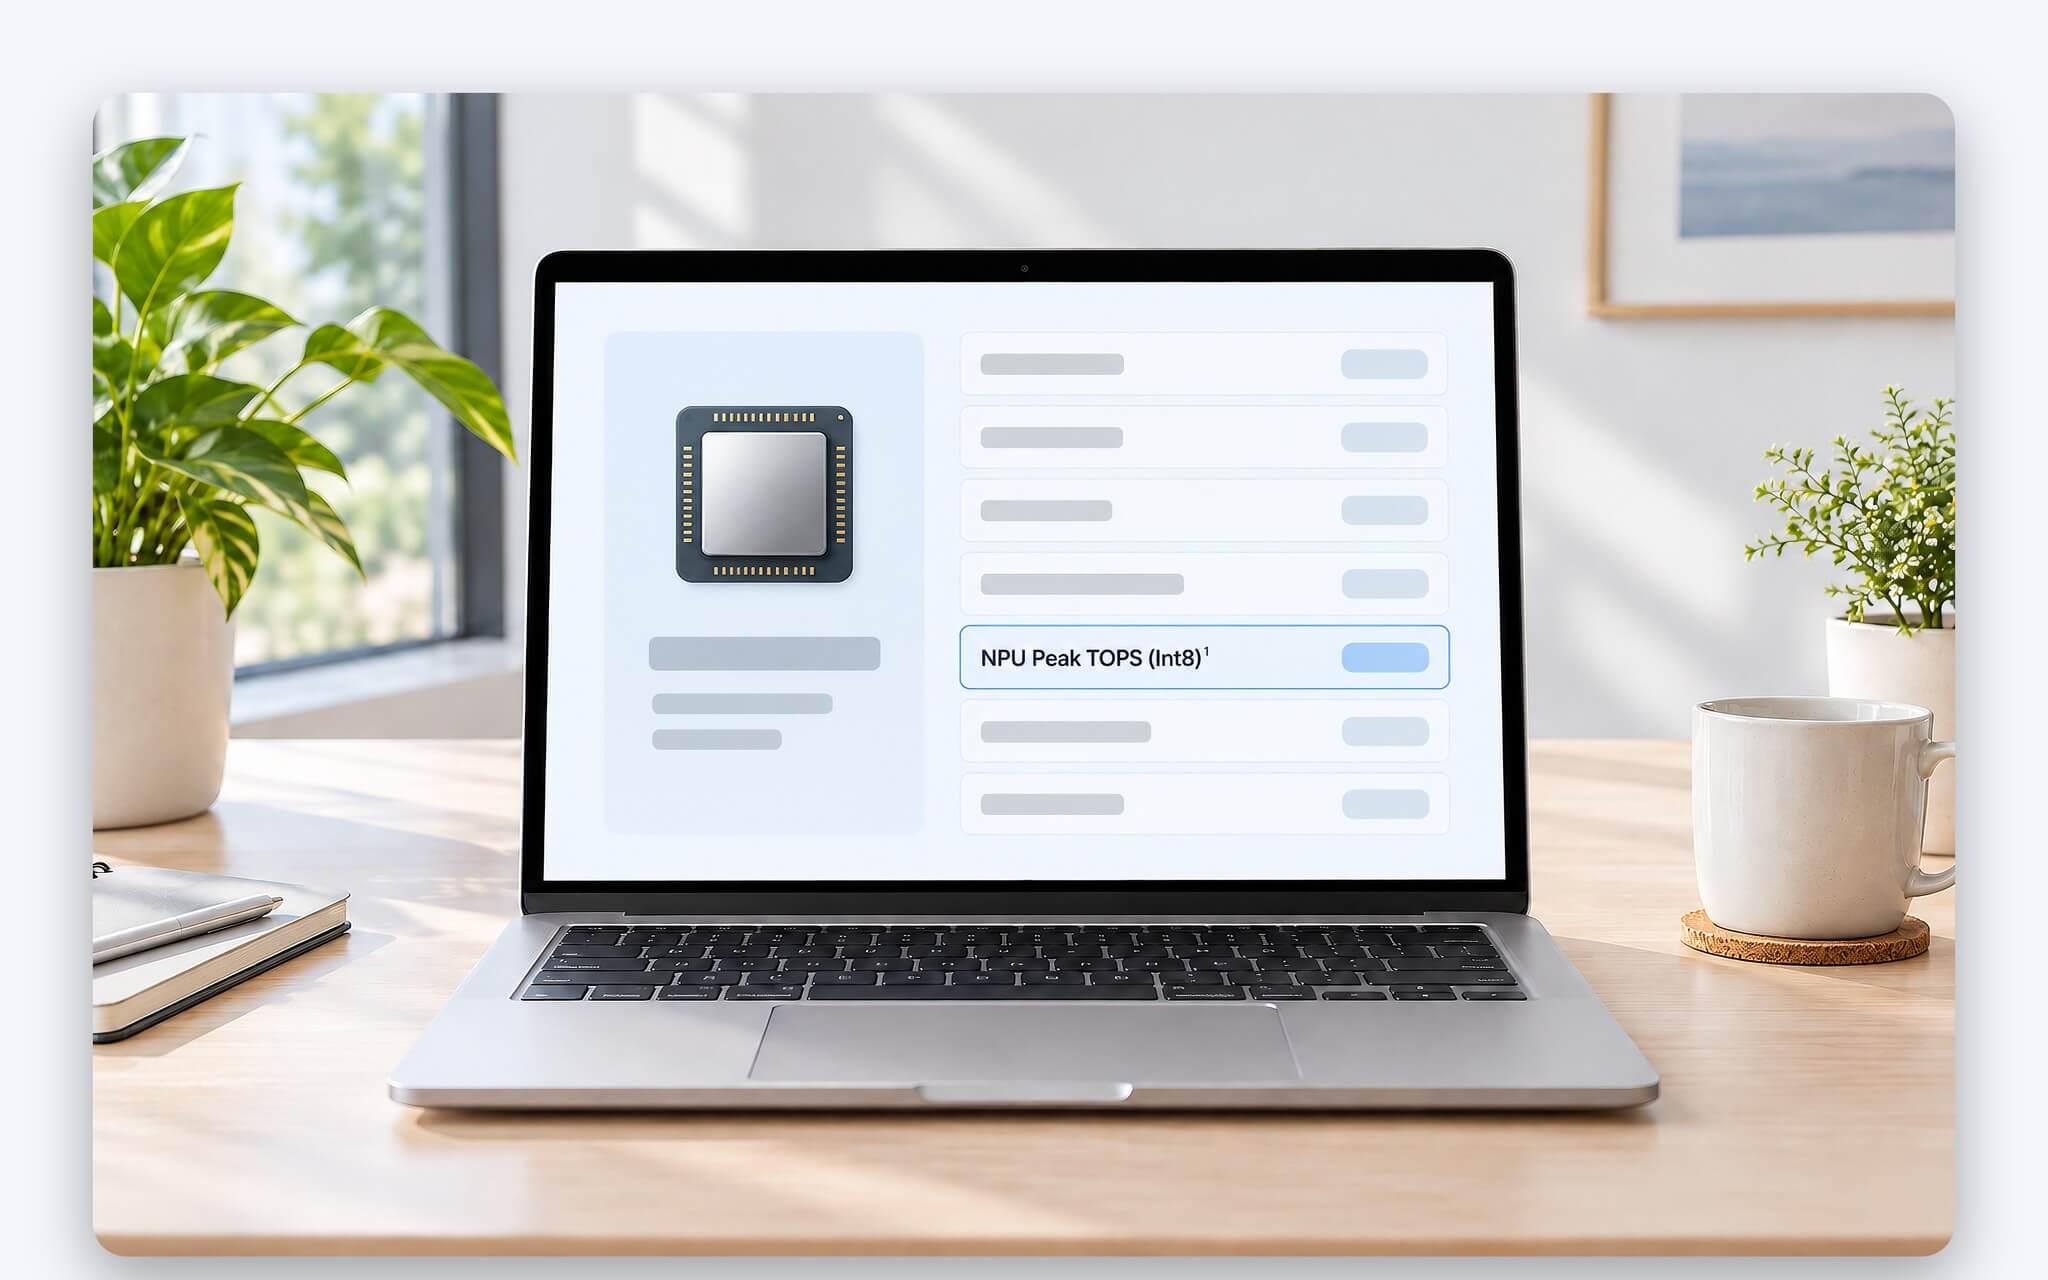
TOPS là số nghìn tỷ phép toán mỗi giây, nhưng con số này chỉ phản ánh thực chất khi đi kèm kiểu dữ liệu. Trang thông số của Intel ghi rõ nhãn NPU Peak TOPS (Int8), theo đó Core Ultra 7 255H đạt 13 TOPS và Core Ultra 7 258V đạt 47 TOPS. AMD công bố Ryzen AI 7 350 có NPU tới 50 TOPS, còn bảng SKU của Qualcomm ghi Snapdragon X Elite X1E-78-100 có Hexagon NPU tới 45 TOPS, cả hai không ghi kiểu số ngay cạnh con số.
| Chip (ví dụ trên laptop 2024 trở lên) | NPU TOPS hãng công bố | Kiểu số ghi kèm | TOPS toàn nền tảng |
|---|---|---|---|
| Intel Core Ultra 7 255H | 13 | Số nguyên 8 bit, theo trang thông số Intel | 96 |
| Snapdragon X Elite X1E-78-100 | 45 | Không ghi trong bảng SKU của Qualcomm | Không công bố |
| Intel Core Ultra 7 258V | 47 | Số nguyên 8 bit, theo trang thông số Intel | 115 |
| AMD Ryzen AI 7 350 | 50 | Không ghi trên trang sản phẩm AMD | 66 |
Cách quy đổi nằm trong datasheet Intel Core Ultra 200H và 200U. Mỗi khối Neural Compute Engine của NPU dòng này có 2.048 bộ MAC, cho 4 TOPS ở 8 bit hoặc 2 TFLOPS ở FP16 tại xung nhịp 1 GHz. Một phép MAC gồm một phép nhân và một phép cộng, nên 2.048 nhân 2 nhân 1 tỷ xấp xỉ 4,1 nghìn tỷ phép tính mỗi giây. Cùng một mạch, thông lượng ở định dạng 16 bit chỉ bằng một nửa, vì vậy 13 TOPS không thể hiểu là 13 TFLOPS khi mô hình chạy dấu phẩy động.
Chú thích thứ hai cần đọc là độ thưa (sparsity). Datasheet Core Ultra 200V cho biết cơ chế bỏ qua các phép tính với giá trị 0 có thể nâng TOPS hiệu dụng lên tối đa 4 lần, nên một con số không ghi rõ tính dày hay tính thưa có thể không cùng thước đo với chip khác. Bảng của Qualcomm còn đặt 45 TOPS của NPU cạnh 3,8 TFLOPs của GPU Adreno, hai đơn vị khác hẳn nhau. Bài Chỉ số TOPS của NPU: Đọc đúng và đặt cạnh hiệu năng CPU thực tế trình bày cách đặt con số này cạnh hiệu năng CPU của từng chip.
Tác vụ nào hợp INT8 và tác vụ nào cần giữ FP16
Các tính năng AI chạy nền trên laptop như làm mờ phông nền webcam, lọc tạp âm micro hay nhận diện chữ trong ảnh đều là suy luận trên mô hình đã cố định, nhóm việc thường được lượng tử hóa về INT8 để vận hành liên tục mà vẫn giữ thời lượng pin. Microsoft đặt điều kiện NPU 40 TOPS cho tính năng Recall của Copilot+ PC, kèm 16 GB RAM, 8 bộ xử lý logic và 256 GB lưu trữ. Bài Copilot PC là gì: NPU 40 TOPS xử lý AI cục bộ ra sao? giải thích ngưỡng này áp vào từng dòng chip ra sao.
Mô hình ngôn ngữ và mô hình tạo ảnh chạy cục bộ là vùng giao thoa. Trọng số thường được nén xuống 8 bit hoặc 4 bit để vừa dung lượng RAM, nhưng một phần phép tính vẫn ở dạng 16 bit để giữ chất lượng câu chữ và chi tiết hình ảnh. AMD từng giới thiệu mô hình SDXL Turbo dạng Block FP16 với mô tả kết hợp độ chính xác của định dạng 16 bit và hiệu năng của định dạng 8 bit, cho thấy hãng chip cũng đang tìm cách dung hòa hai hướng.
Huấn luyện, tinh chỉnh mô hình hay các bài toán mô phỏng khoa học cần dải giá trị rộng thì vẫn thuộc về số dấu phẩy động 16 hoặc 32 bit trên GPU. Một laptop có chỉ số TOPS cao không vì thế mà thay thế được GPU trong nhóm công việc này. Khi đọc cấu hình, cách an toàn là tách thành ba câu hỏi: tác vụ là suy luận hay huấn luyện, mô hình dùng kiểu số nào, và phần mềm có gọi tới NPU hay không.
Câu hỏi thường gặp (FAQ)
Mô hình chạy số nguyên có luôn kém chính xác hơn bản gốc?
Không hẳn. Với mô hình được hiệu chỉnh tốt, mức chênh lệch về chất lượng có thể rất nhỏ, nhất là ở các mạng thị giác máy tính. Sai số tăng khi mô hình có nhiều giá trị ngoại lai hoặc bị lượng tử hóa toàn bộ, kể cả những lớp nhạy. Cách duy nhất để biết chính xác là đo lại chất lượng trên tập kiểm thử sau khi chuyển đổi.
Vì sao TOPS của NPU và GPU khó đặt cạnh nhau?
Trang thông số Intel ghi Core Ultra 7 258V có NPU 47 TOPS và GPU 64 TOPS, đều tính theo số nguyên 8 bit, nên hai con số này so sánh được. Bảng của Qualcomm ghi NPU 45 TOPS còn GPU 3,8 TFLOPs, khác đơn vị và không cùng kiểu số, nên không thể dùng để kết luận khối nào mạnh hơn.
Một byte dữ liệu số nguyên lưu được bao nhiêu giá trị?
Dạng có dấu lưu 256 giá trị từ -128 đến 127, dạng không dấu từ 0 đến 255. Datasheet Intel ghi NPU hỗ trợ cả hai dạng, ký hiệu I8 và U8. Để biểu diễn số thực, mỗi giá trị số nguyên 8 bit đi kèm hệ số tỷ lệ và điểm không do bước lượng tử hóa tính ra.
Laptop không có NPU có chạy được mô hình đã lượng tử hóa?
Có. CPU và GPU vẫn chạy được mô hình đã chuyển đổi thông qua các thư viện như ONNX Runtime hay OpenVINO, chỉ chênh lệch ở hiệu năng và mức tiêu thụ điện. Datasheet Intel Core Ultra 200V cho biết CPU hỗ trợ tập lệnh AVX2 VNNI để tăng tốc tác vụ học sâu, còn với dữ liệu 16 bit dấu phẩy động, chip chuyển nhanh lên FP32 để tính rồi lưu lại ở dạng 16 bit.
0 phản hồi cho “INT8 là gì - Vì sao NPU tính AI bằng số nguyên 8 bit thay vì FP16”