
Apple gọi M5 là bước tiến lớn về AI của Apple Silicon, và phần thay đổi then chốt không nằm ở CPU mà ở GPU. Neural Accelerator là khối phần cứng chuyên nhân ma trận được đặt ngay trong mỗi nhân GPU, nói gọn là bộ tăng tốc AI tích hợp vào nhân đồ họa. Theo thông cáo của Apple, GPU 10 nhân của M5 nhờ khối này đạt sức tính AI đỉnh gấp hơn 4 lần M4. Hiểu khối này khác Neural Engine ra sao, phần mềm gọi tới nó bằng cách nào và con số hãng công bố được đo trong điều kiện gì sẽ giúp đọc đúng mức tăng thực tế.
Neural Accelerator là khối nhân ma trận nằm trong từng nhân GPU
Mạng nơ-ron, từ mô hình ngôn ngữ đến mô hình tạo ảnh, quy về rất nhiều phép nhân ma trận dạng C = A×B + C. GPU truyền thống xử lý phép toán này bằng các đơn vị số học đa dụng, tức phải chia nhỏ thành hàng nghìn lệnh nhân cộng riêng lẻ. Khối mới là mạch chuyên dụng làm trọn phép nhân ma trận theo từng khối dữ liệu, nên cùng một chu kỳ xung nhịp xử lý được khối lượng phép tính lớn hơn nhiều.
Trong buổi Tech Talk dành cho nhà phát triển, kỹ sư Apple mô tả mỗi shader core của GPU M5 có riêng một Neural Accelerator, đặt cạnh các pipeline sẵn có như ALU và khối dò tia. Cách bố trí này khiến năng lực tính ma trận tăng tương ứng với số nhân GPU, nên cấu hình nhiều nhân GPU hơn có ưu thế rõ ở tải AI. Bản M5 tiêu chuẩn có 10 nhân GPU nên có 10 khối tăng tốc, còn M5 Pro và M5 Max ra mắt tháng 3/2026 cũng được Apple xác nhận có khối tăng tốc này trong mỗi nhân GPU.
Ngoài phép nhân ma trận, khối này còn tăng tốc phép tích chập, dạng toán phổ biến trong mô hình xử lý ảnh và mô hình khuếch tán. Apple cho biết phép nhân ma trận chạy trên khối chuyên dụng nhanh hơn từ 4 đến 8 lần tùy độ chính xác số học. Mức chênh lệch này phụ thuộc định dạng dữ liệu đầu vào, vì định dạng càng gọn thì mỗi chu kỳ càng xử lý được nhiều phần tử. Đây là con số đo ở cấp phép toán, chưa phải mức tăng của trọn một ứng dụng.
Neural Engine và khối tăng tốc trong GPU khác nhau ở điểm nào
Neural Engine là bộ xử lý AI độc lập, tồn tại trên chip Apple từ nhiều thế hệ trước. Trên M5, Neural Engine vẫn được duy trì với 16 nhân và được Apple mô tả là nhanh hơn thế hệ trước, phục vụ Apple Intelligence cùng framework Foundation Models. Thông cáo M5 không nêu con số TOPS cho khối này, trong khi Neural Engine của M4 được công bố đạt tối đa 38 nghìn tỷ phép tính mỗi giây. Hai khối cùng tồn tại, không khối nào thay thế khối nào.
| Tiêu chí | Neural Accelerator | Neural Engine |
|---|---|---|
| Vị trí trên chip | Trong mỗi nhân GPU, 10 khối trên M5 | Khối riêng 16 nhân, tách khỏi GPU |
| Phép toán chính | Nhân ma trận, tích chập | Suy luận mô hình đã biên dịch qua Core ML |
| Cách phần mềm gọi tới | Tensor APIs trong Metal 4, MPS, MPSGraph, Core ML | Core ML với tùy chọn all hoặc cpuAndNeuralEngine |
| Số liệu Apple công bố | Sức tính AI đỉnh của GPU gấp hơn 4 lần M4 | M4 đạt 38 nghìn tỷ phép tính/giây, M5 không nêu |
| Tác vụ tiêu biểu | LLM qua MLX, LM Studio, mô hình diffusion | Apple Intelligence, Foundation Models |
Điểm mấu chốt nằm ở khả năng lập trình. Thông cáo M5 nêu rõ nhà phát triển có thể lập trình trực tiếp Neural Accelerator bằng Tensor APIs trong Metal 4, nghĩa là phép nhân ma trận được viết ngay trong shader cùng các bước xử lý đồ họa khác. Neural Engine thì được khai thác qua Core ML, nơi mô hình đã được chuyển đổi sẵn và hệ điều hành tự sắp xếp thứ tự thực thi các lớp.
Vì nằm trong GPU, bộ tăng tốc ma trận dùng chung bộ nhớ đệm, thanh ghi và bộ điều phối luồng với phần đồ họa. Kết quả nhân ma trận có thể giữ lại trong bộ nhớ trên chip để đi tiếp qua hàm kích hoạt, không phải ghi ra bộ nhớ chính rồi đọc lại. Tài liệu Core ML gợi ý giới hạn mô hình ở CPU khi ứng dụng chạy nền hoặc đang dùng GPU cho tác vụ nặng khác, cho thấy việc chọn khối xử lý luôn gắn với tình trạng tải của cả hệ thống.
Core ML và Metal 4 chia tải AI giữa từng khối
Ở tầng cao, Core ML cho phép ứng dụng khai báo khối xử lý được phép dùng qua tham số MLComputeUnits. Tùy chọn all để hệ điều hành tự chọn giữa CPU, GPU và Neural Engine. Tùy chọn cpuAndGPU loại Neural Engine ra, còn cpuAndNeuralEngine thì loại GPU. Như vậy cùng một mô hình Core ML, tùy cấu hình, có thể chạy trên Neural Engine hoặc trên GPU có Neural Accelerator, hiệu năng vì thế có thể chênh lệch.
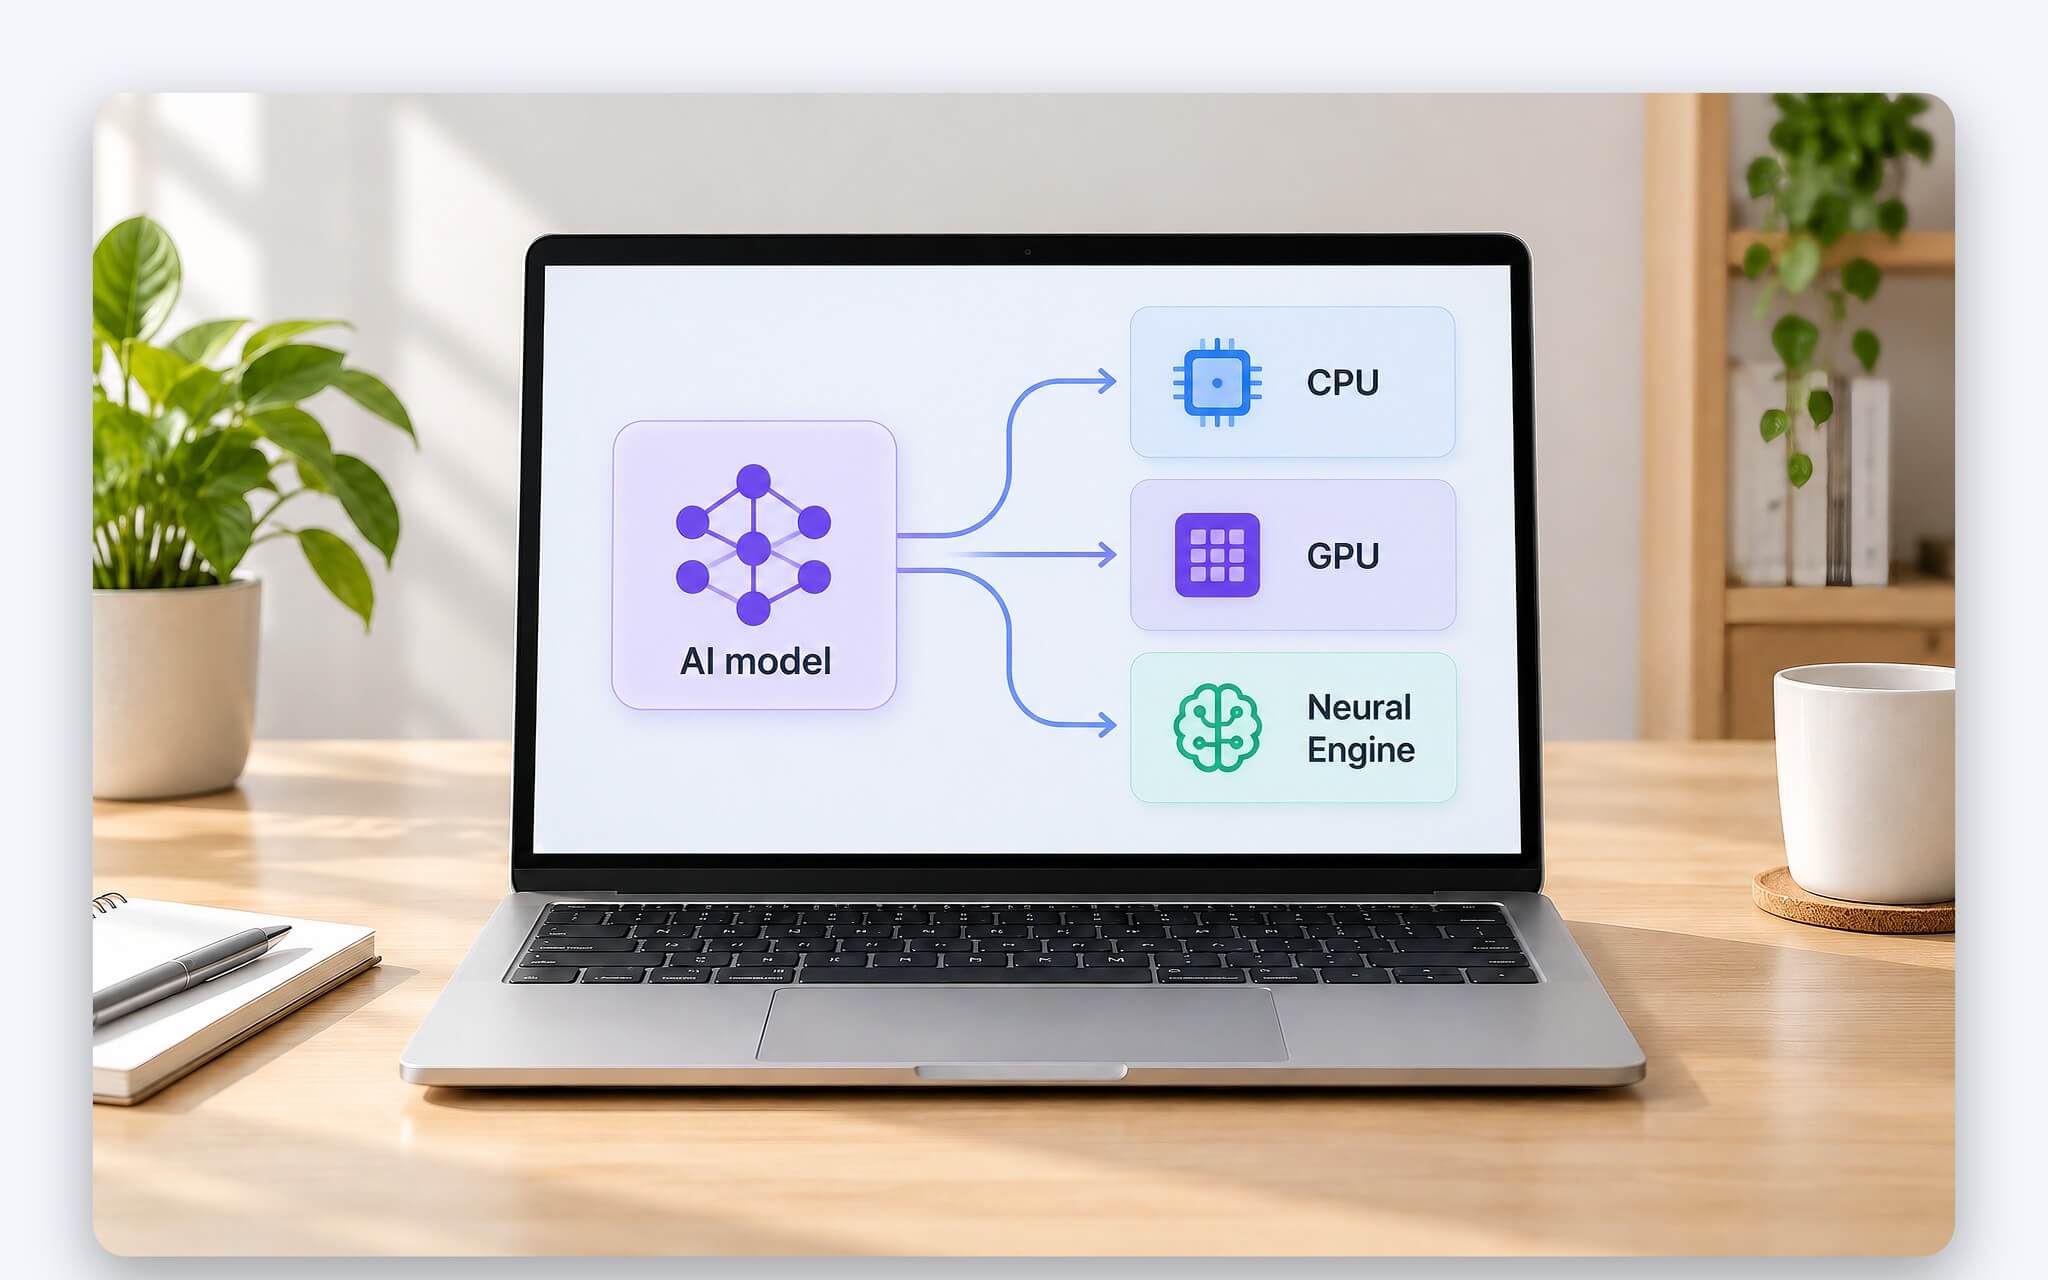
Ở tầng thấp, Metal 4 đưa vào TensorOps, giao diện trong Metal Shading Language để viết phép nhân ma trận và tích chập ngay trong shader. Apple khuyến nghị các kernel tự viết bằng API ma trận theo nhóm SIMD cũ nên chuyển sang TensorOps. Ưu điểm là giao diện này chạy được trên GPU từ M1 tới M5: chip có khối tăng tốc ma trận thì dùng phần cứng chuyên dụng, chip cũ hơn thì quay về mã shader đã tối ưu, nhà phát triển không phải viết hai nhánh code.
Trong bản demo nhân hai ma trận 4K×4K, phiên bản dùng TensorOps nhanh hơn bản shader thường hơn 4 lần, còn khi sắp xếp lại thứ tự truy cập dữ liệu thì nhanh gần 7 lần. Mức sử dụng khối tăng tốc đi từ 0% ở bản đầu lên gần 100% ở bản cuối. Ví dụ này cho thấy phần cứng chỉ được tận dụng khi mã được viết đúng cách, bằng API tensor và tổ chức dữ liệu hợp lý.
Vì sao Neural Accelerator rút ngắn token đầu hơn bước sinh chữ
Nhóm Machine Learning Research của Apple thử MLX trên MacBook Pro 14 inch M5 bộ nhớ 24GB, so với cấu hình M4 tương tự. Mỗi lượt chạy dùng lời nhắc dài 4.096 token và sinh thêm 128 token. Thời gian ra token đầu tiên nhanh hơn 3,33 đến 4,06 lần tùy mô hình, trong khi tốc độ sinh các token kế tiếp chỉ tăng 19% đến 27%. Mô hình 14B dạng dense có token đầu dưới 10 giây, còn mô hình MoE 30B dưới 3 giây. Cách đo riêng độ trễ token đầu và token mỗi giây có trong bài Token mỗi giây khi chạy AI Local - Token/s là gì, đọc sao cho đúng.
| Mô hình chạy qua MLX | Token đầu nhanh hơn M4 (lần) | Sinh token nhanh hơn M4 (lần) | Bộ nhớ dùng (GB) |
|---|---|---|---|
| Qwen3 1.7B BF16 | 3,57 | 1,27 | 4,40 |
| Qwen3 8B BF16 | 3,62 | 1,24 | 17,46 |
| Qwen3 8B 4-bit | 3,97 | 1,24 | 5,61 |
| Qwen3 14B 4-bit | 4,06 | 1,19 | 9,16 |
| gpt-oss 20B MXFP4 | 3,33 | 1,24 | 12,08 |
| Qwen3 30B-A3B 4-bit (MoE) | 3,52 | 1,25 | 17,31 |
Nguyên nhân nằm ở bản chất hai giai đoạn. Giai đoạn đọc lời nhắc, còn gọi là prefill, xử lý cả nghìn token cùng lúc nên là tải nặng về tính toán, đúng sở trường của Neural Accelerator. Giai đoạn sinh từng token sau đó lại bị giới hạn bởi băng thông bộ nhớ, vì mỗi token mới đều phải đọc lại toàn bộ trọng số. Băng thông M5 là 153GB/s so với 120GB/s của M4, tăng 28%, khớp với mức tăng 19% đến 27% ở bước sinh chữ.
Hiện tượng tính nhanh nhưng nghẽn ở bộ nhớ cũng xuất hiện trên NPU của laptop Windows, như phân tích trong bài NPU 50 TOPS chạy local LLM: Tính toán nhanh, nhưng lại nghẽn về băng thông. Với tác vụ có lời nhắc dài như tóm tắt tài liệu, phần prefill chiếm nhiều thời gian hơn nên mức tăng ở token đầu có ý nghĩa hơn.
Kết xuất thần kinh và tạo ảnh diffusion hưởng lợi theo cách khác
Mô hình diffusion tái tạo ảnh bằng cách khử nhiễu qua nhiều bước, mỗi bước là một lượt suy luận nặng về tích chập và nhân ma trận. Khác với bước sinh chữ của LLM, mỗi bước khử nhiễu đều xử lý trọn tấm ảnh nên tải nghiêng về tính toán. Apple đo mô hình FLUX-dev 4-bit 12 tỷ tham số tạo ảnh 1024×1024 qua MLX, kết quả trên M5 nhanh hơn M4 trên 3,8 lần.
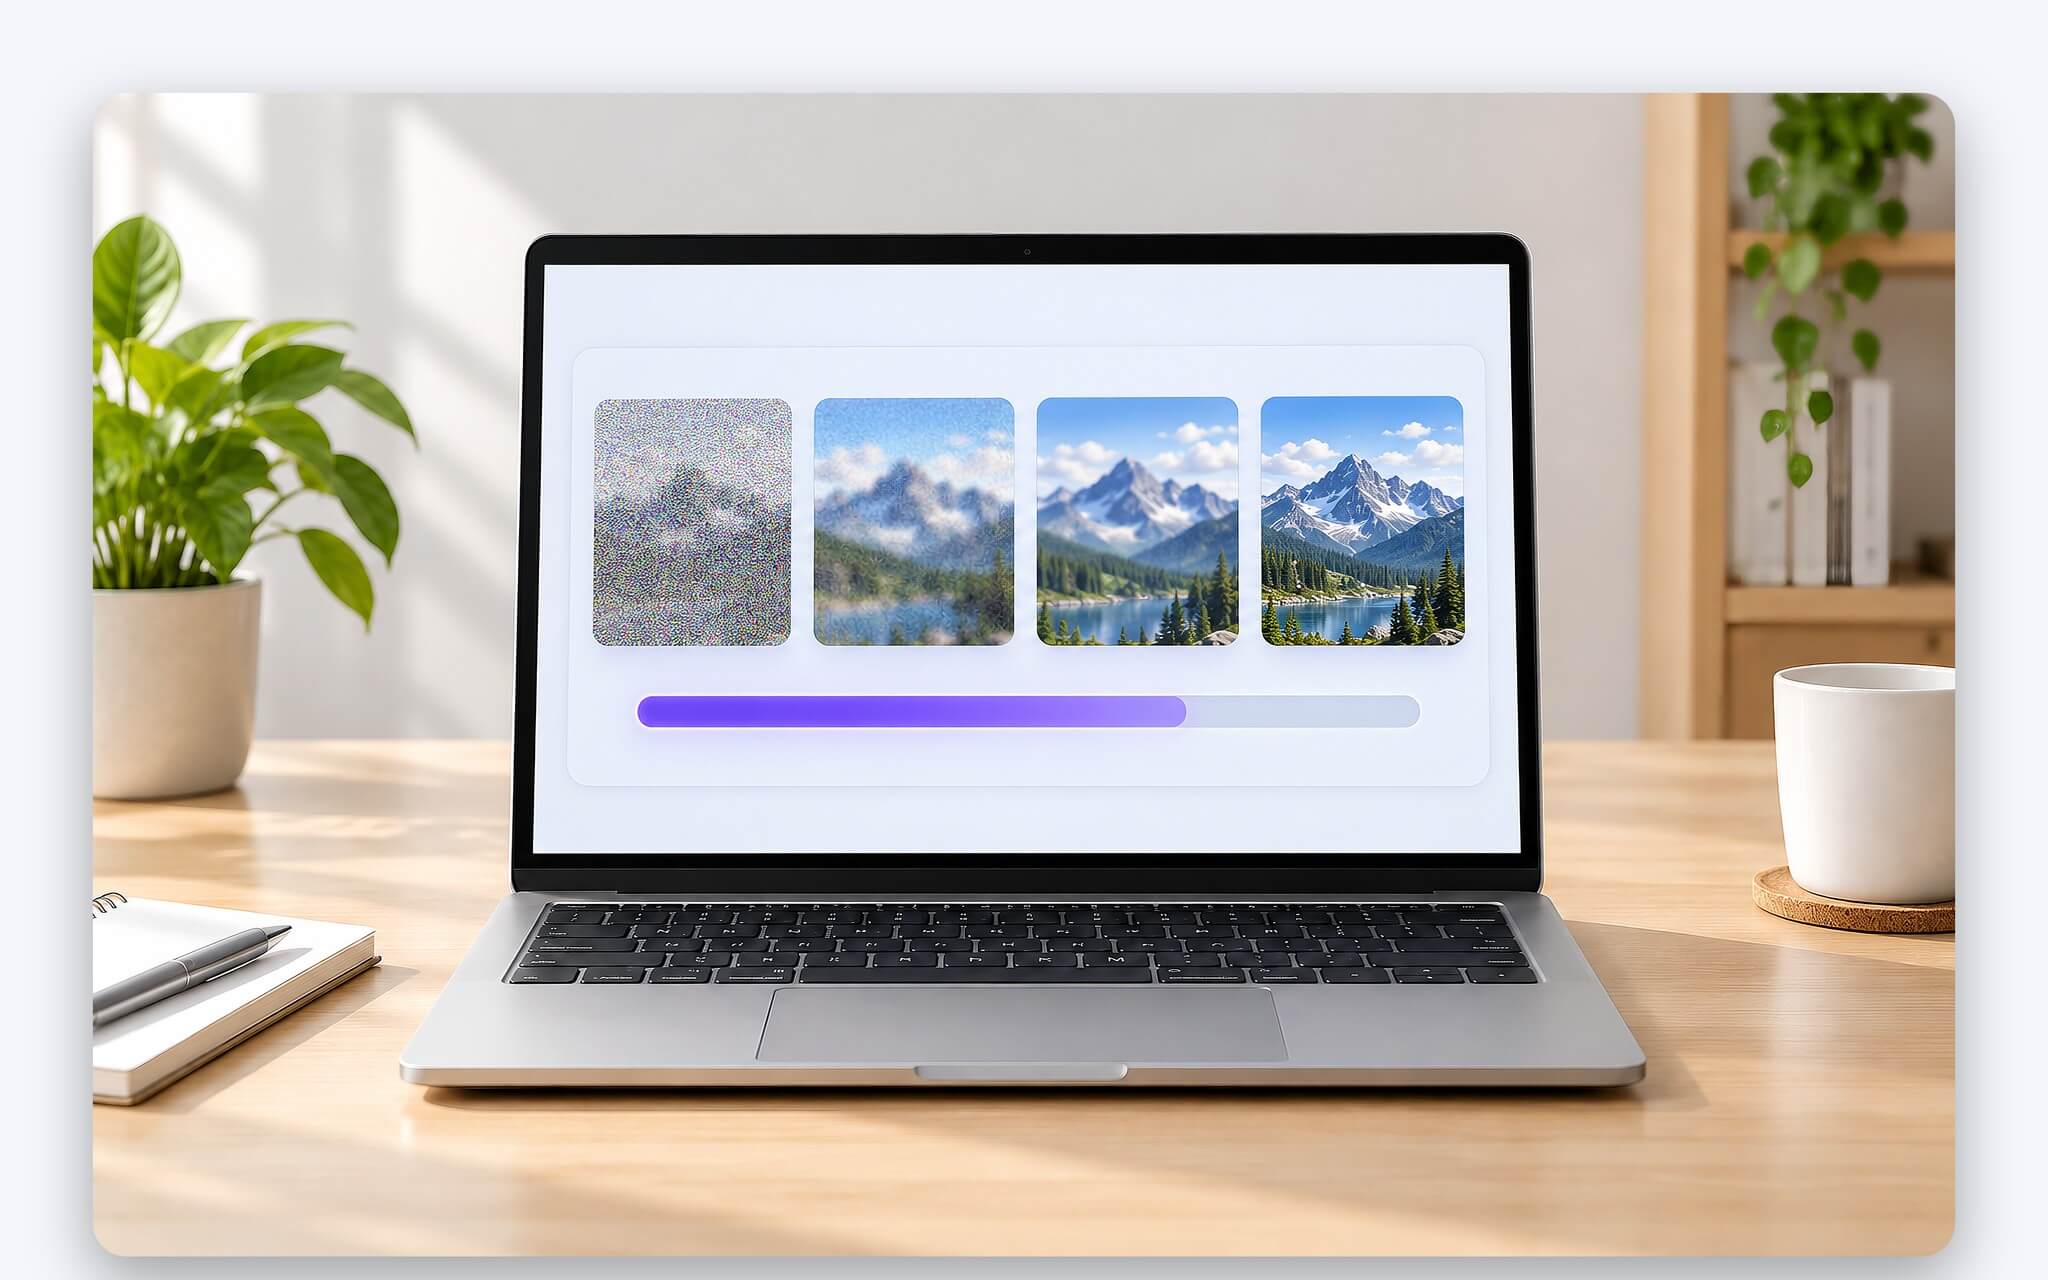
Kết xuất thần kinh là hướng đồ họa trong đó mô hình học máy đảm nhận một phần việc dựng hình, chẳng hạn nâng độ phân giải hoặc khử nhiễu khung hình dò tia. MetalFX của Apple đã dùng học máy bên trong. Khi phép suy luận diễn ra ngay trong nhân GPU, khung hình không phải chuyển sang bộ xử lý AI riêng rồi quay lại, giảm độ trễ cho hiệu ứng thời gian thực.
Phần đồ họa truyền thống của M5 cũng được nâng cấp riêng: Apple công bố hiệu năng đồ họa cao hơn M4 tới 30%, ứng dụng có dò tia tăng tới 45% nhờ khối dò tia thế hệ ba. Theo chú thích trong thông cáo ra mắt M5 của Apple, các số này đo tháng 9/2025 trên MacBook Pro 14 inch M5 bản tiền sản xuất 10 nhân CPU, 10 nhân GPU, so với MacBook Pro 14 inch M4 cùng số nhân. Đây là số hãng tự đo bằng một số bài kiểm tra chọn lọc, chưa phải kết quả do bên thứ ba xác minh.
Phần mềm cần điều kiện gì để gọi được Neural Accelerator trong GPU
Điều kiện đầu tiên là phiên bản hệ điều hành. Bài thử nghiệm LLM bằng MLX trên M5 của nhóm Apple Machine Learning Research ghi rõ MLX cần macOS 26.2 trở lên mới khai thác được Neural Accelerator của M5. Các kiểu dữ liệu cũng mở dần theo bản cập nhật: bfloat16 từ bản 26.1, số nguyên 4 bit và 8 bit từ bản 26.4, còn macOS 27 và iOS 27 bổ sung số thực 8 bit, 4 bit và số nguyên 2 bit. Mô hình lượng tử hóa sâu chỉ tăng tốc đầy đủ khi hệ điều hành hỗ trợ đúng định dạng.
| Phiên bản hệ điều hành | Bổ sung liên quan khối tăng tốc AI | Nguồn Apple |
|---|---|---|
| macOS, iOS 26.1 | Tensor kiểu bfloat16 | Tech Talk M5 và A19 GPU |
| macOS 26.2 | MLX khai thác khối tăng tốc trong GPU | Apple Machine Learning Research |
| macOS, iOS 26.4 | Tensor số nguyên 4 bit và 8 bit | Tech Talk M5 và A19 GPU |
| macOS, iOS 27 | Số thực 8 bit, 4 bit, số nguyên 2 bit, mặt phẳng hệ số tỷ lệ | WWDC26, phiên 330 |
Điều kiện thứ hai là framework. Theo Apple, MLX, llama.cpp và PyTorch đã dùng Neural Accelerator ở tầng dưới, nên công cụ dựng trên các nền này như LM Studio được hưởng lợi sau khi cập nhật. Ứng dụng tự viết kernel Metal bằng API cũ thì phải chuyển sang TensorOps. Phần mềm chỉ xử lý AI trên CPU, hoặc cấu hình Core ML ở chế độ cpuAndNeuralEngine, sẽ không chạm tới khối này. Về lượng tử hóa số nguyên, bài INT8 là gì - Vì sao NPU tính AI bằng số nguyên 8 bit thay vì FP16 giải thích lý do định dạng gọn giúp tăng tốc.
Điều kiện thứ ba là dung lượng bộ nhớ hợp nhất. Neural Accelerator không làm mô hình nhỏ lại, nên dung lượng bộ nhớ phải đáp ứng kích thước mô hình: Qwen3 8B BF16 cần 17,46GB, vượt xa cấu hình 16GB. M5 tiêu chuẩn hỗ trợ tối đa 32GB, M5 Pro tới 64GB với băng thông 307GB/s, M5 Max tới 128GB với 614GB/s. Mô hình lớn hơn bộ nhớ thì khối tăng tốc trong GPU dù nhanh tới đâu cũng không cứu được.
Câu hỏi thường gặp (FAQ)
Neural Accelerator có thay thế Neural Engine trên M5 không?
Không. M5 vẫn giữ Neural Engine 16 nhân phục vụ Apple Intelligence và mô hình Core ML. Khối tăng tốc mới là phần bổ sung nằm trong GPU, dành cho tải AI chạy qua GPU như MLX, LM Studio hay mô hình tạo ảnh.
Con số gấp 4 lần M4 được đo trong điều kiện nào?
Đó là sức tính AI đỉnh của GPU do Apple công bố, đo tháng 9/2025 trên MacBook Pro 14 inch M5 bản tiền sản xuất 10 nhân GPU so với M4 10 nhân GPU. Trong thử nghiệm LLM qua MLX, token đầu nhanh hơn 3,33 đến 4,06 lần.
Chip M1 đến M4 có hỗ trợ TensorOps không?
Có. Theo Apple, TensorOps chạy trên GPU từ M1 tới M5. Chip không có Neural Accelerator sẽ chạy bằng mã shader đã tối ưu, nên ứng dụng vẫn hoạt động nhưng không có mức tăng tốc phần cứng như M5.
0 phản hồi cho “Neural Accelerator là gì - Khối tăng tốc AI nằm trong từng nhân GPU Apple M5”