
Nhiều laptop văn phòng đang lưu hành vẫn chỉ có 8GB RAM, nên bài toán chạy trợ lý AI riêng tư ngay trên cấu hình này luôn mang giá trị thực tế. Granite 4.2 do IBM phát hành ngày 25/08/2026 có bản mô hình 3B với tệp GGUF Q4_K_M chỉ 2,24 GB, đủ gọn để nạp vào bộ nhớ khiêm tốn. Bài viết phân tích dung lượng từng mức lượng tử, bộ đệm ngữ cảnh, chế độ suy nghĩ và điểm chuẩn chính thức nhằm xác định ngưỡng vận hành hợp lý cho laptop 8GB.
Granite 4.2 là thế hệ suy luận dense mới nhất của IBM
Theo model card của bản 3B trên Hugging Face, Granite 4.2 ra mắt ngày 25/08/2026 với ba cỡ 3B, 8B và 30B, cùng giấy phép Apache 2.0 cho phép khai thác thương mại lẫn nghiên cứu. Cả ba đều là Transformer dense chỉ gồm khối giải mã, được hậu huấn luyện từ nền Granite 4.1 phát hành ngày 29/04/2026. Điểm mới cốt lõi là năng lực suy nghĩ tích hợp sẵn: mô hình viết chuỗi lập luận trong khối think trước khi trả lời, đồng thời hỗ trợ gọi hàm để kết nối công cụ bên ngoài. Ngữ cảnh gốc đạt 128K token, giai đoạn mở rộng đẩy lên 512K.
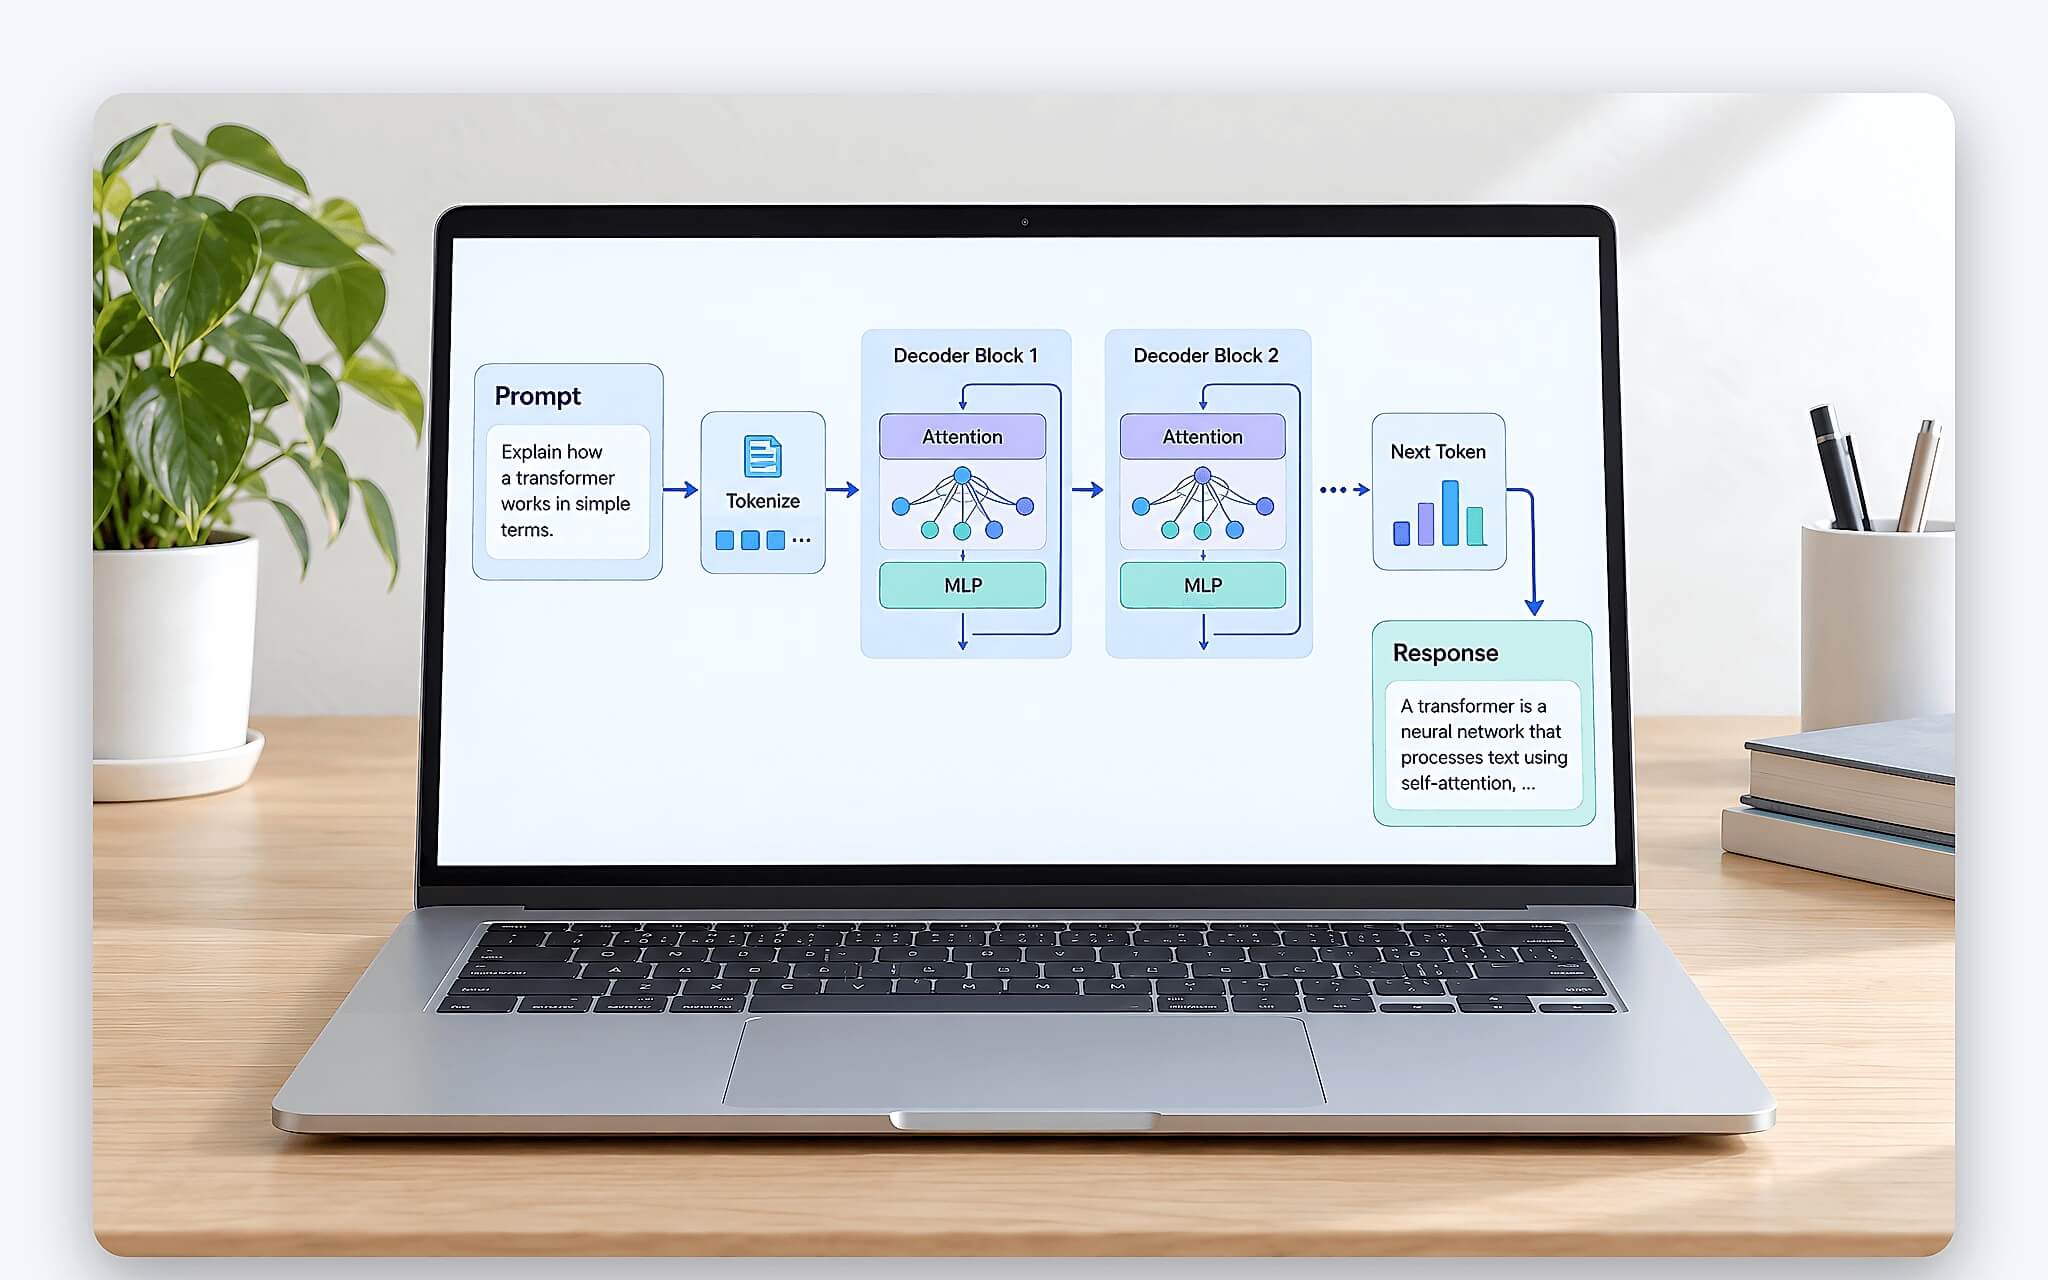
Dòng IBM Granite từng gây chú ý ở thế hệ 4.0 ra mắt ngày 02/10/2025 với các bản H lai giữa lớp Mamba-2 và lớp attention, trên Ollama vẫn còn các thẻ granite4:micro-h, granite4:tiny-h hay granite4:small-h. Thế hệ 4.2 quay về kiến trúc dense thuần, dùng Grouped Query Attention với 40 đầu attention và 8 đầu KV ở bản 3B. Khác biệt về bản chất này tác động trực tiếp lên bộ nhớ: lớp Mamba giữ trạng thái kích thước cố định, còn lớp attention phải lưu khóa và giá trị cho từng token, nên bộ đệm KV của bản dense tăng tuyến tính theo độ dài hội thoại.
Với laptop 8GB, cỡ 3B là phương án hợp lý duy nhất trong ba cỡ của Granite 4.2. Bản 8B ở mức Q4_K_M đã nặng 5,35 GB, bản 30B Q4_K_M lên tới 17,72 GB theo kho GGUF chính thức của IBM Granite, vượt xa phần RAM khả dụng sau khi hệ điều hành khởi động. Mô hình 3B nhắm đúng nhóm tác vụ văn phòng: tóm tắt tài liệu nội bộ, soạn bản nháp, trích xuất dữ liệu có cấu trúc JSON và hỗ trợ viết mã ngắn, toàn bộ xử lý ngoại tuyến nên dữ liệu không rời khỏi laptop.
Mười bốn mức lượng tử GGUF của bản 3B nặng bao nhiêu
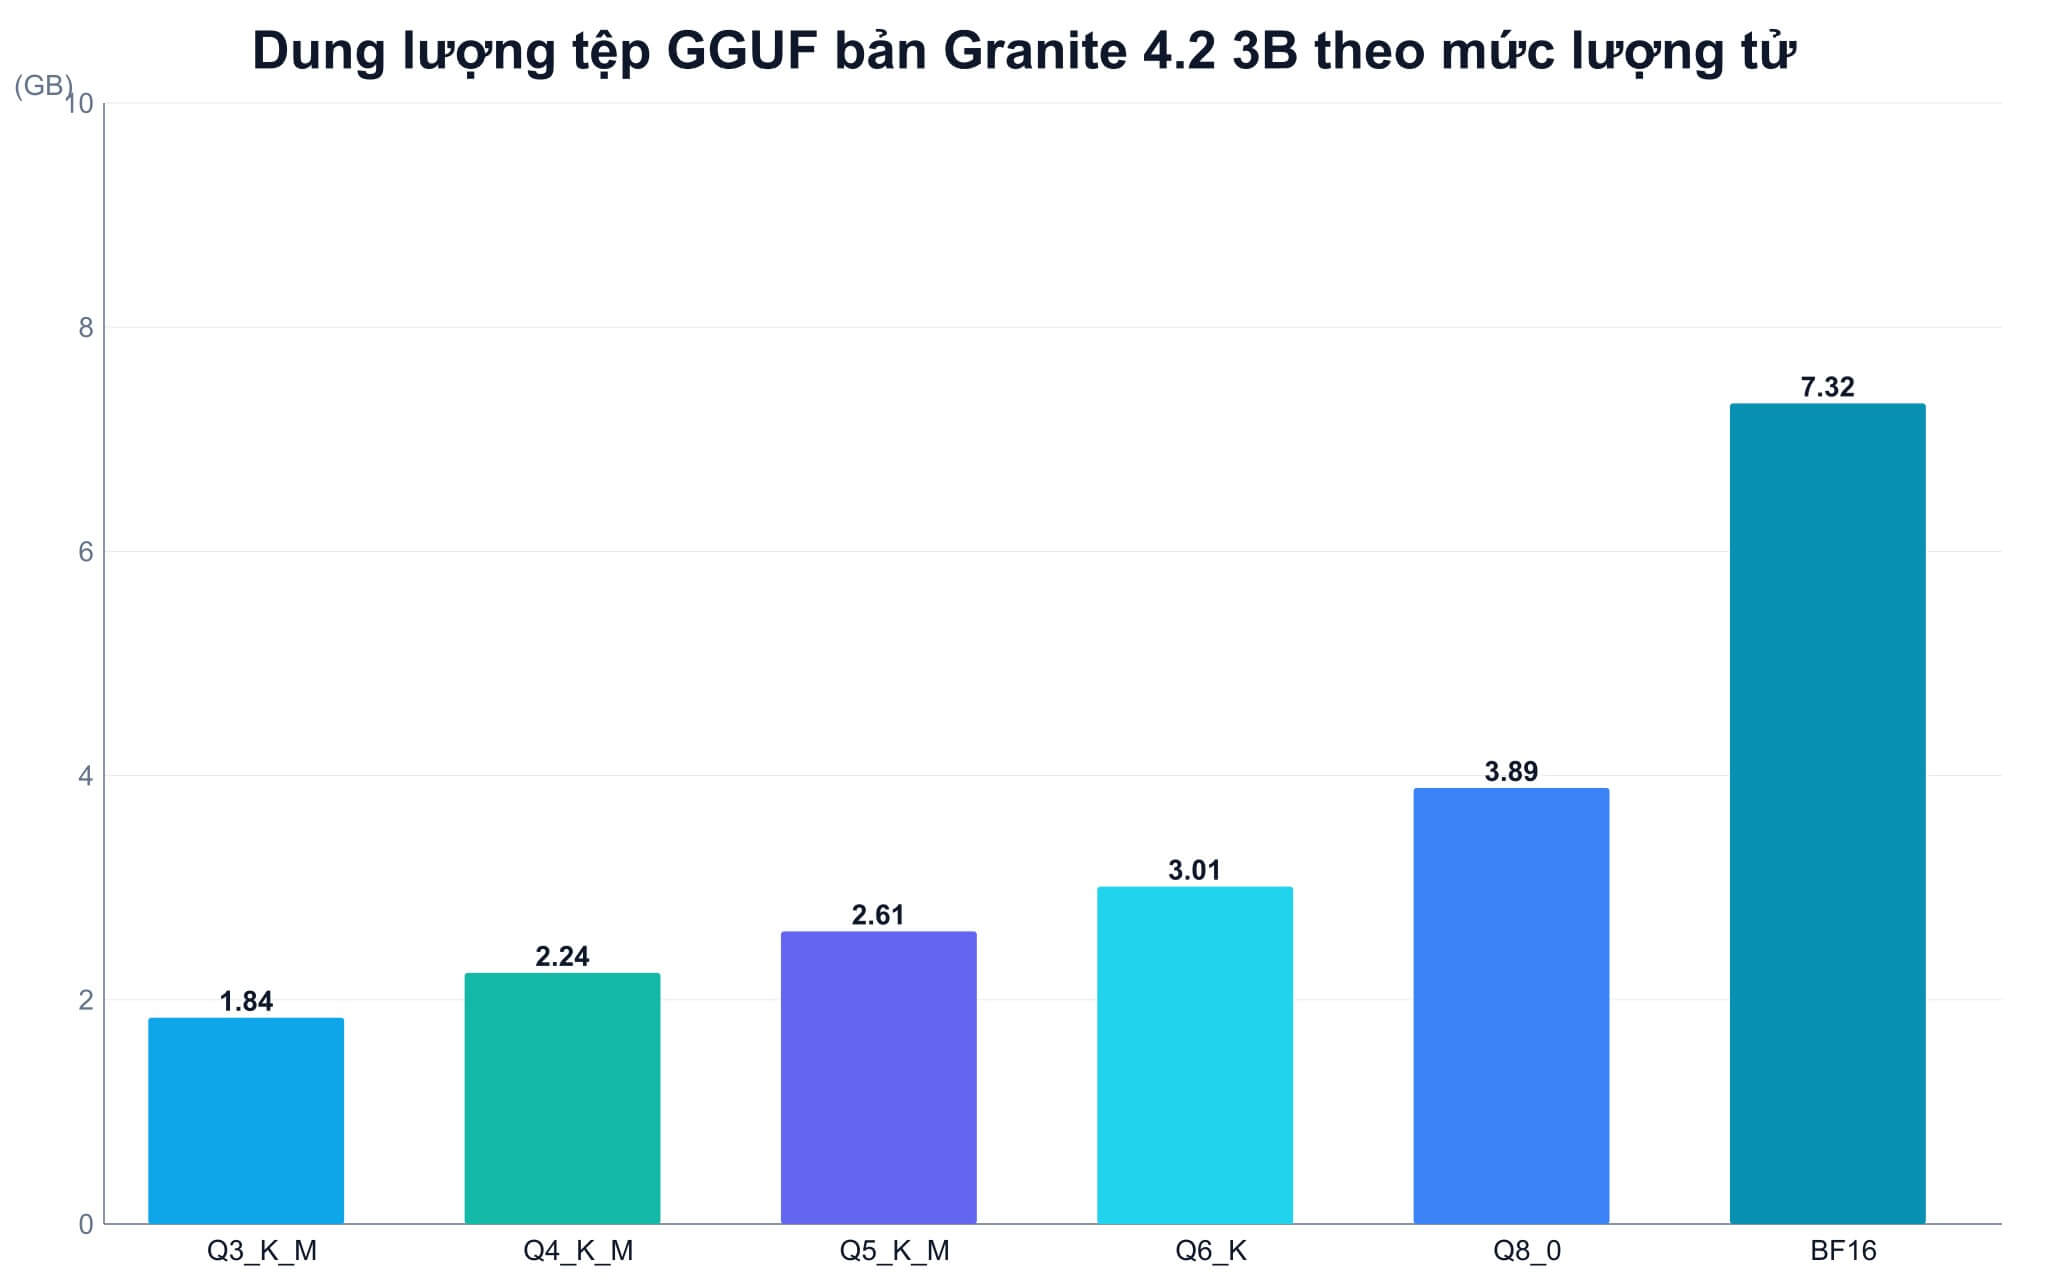
Kho GGUF do đội IBM Granite đăng trên Hugging Face cung cấp 14 mức lượng tử từ Q2_K tới Q8_0, kèm một tệp BF16 nguyên bản 7,32 GB. Ollama phân phối bộ tệp tương đương dưới tên granite4.2, trong đó thẻ granite4.2:3b mặc định trỏ tới bản Q4_K_M 2,2 GB. Trang thẻ Ollama ghi kiến trúc granite với 3,66B tham số, trong khi model card làm tròn thành 3B. Bảng dưới liệt kê sáu mức tiêu biểu theo dung lượng tệp thực trên kho GGUF, quy đổi theo hệ thập phân.
| Mức lượng tử | Dung lượng tệp GGUF (GB) | Chênh so với Q4_K_M (GB) | Thẻ Ollama tương ứng |
|---|---|---|---|
| Q3_K_M | 1,84 | -0,40 | granite4.2:3b-q3_K_M |
| Q4_K_M | 2,24 | 0 | granite4.2:3b (mặc định) |
| Q5_K_M | 2,61 | +0,37 | granite4.2:3b-q5_K_M |
| Q6_K | 3,01 | +0,77 | granite4.2:3b-q6_K |
| Q8_0 | 3,89 | +1,65 | granite4.2:3b-q8_0 |
| BF16 | 7,32 | +5,08 | granite4.2:3b-bf16 |
Lượng tử hóa nén mỗi trọng số từ 16 bit xuống khoảng 3 đến 8 bit, đổi lấy sai số nhỏ trong phép tính. Nhóm K-quant như Q4_K_M chia trọng số thành từng khối và giữ độ chính xác cao hơn cho một số tensor nhạy cảm, nên thường được chọn làm mặc định. Cơ chế khối và hệ số tỷ lệ được phân tích trong bài Quantization Q4: Cấu trúc quyết định Q4_K_M hơn Q4_K_S như thế nào?, phần nền tảng cần nắm khi cân nhắc lùi về Q4_K_S hay tiến lên Q5_K_M cho cùng một mô hình.
Kích thước tệp còn chi phối tốc độ sinh chữ. Khi suy luận trên bộ xử lý CPU, mỗi token mới đòi hỏi đọc lại gần như toàn bộ trọng số từ RAM, nên băng thông bộ nhớ là nút cổ chai chính. Bản Q8_0 nặng 3,89 GB phải chuyển lượng dữ liệu nhiều gấp khoảng 1,7 lần so với Q4_K_M cho mỗi token, kéo tốc độ phản hồi giảm theo tỷ lệ gần tương ứng trên cùng một laptop. Với mô hình 3B trên 8GB RAM, Q4_K_M vừa giữ chất lượng ổn định vừa chừa dư địa cho bộ đệm ngữ cảnh, nên là lựa chọn ưu tiên.
Ngữ cảnh 128K quảng bá không vừa quỹ RAM của laptop 8GB
Con số 128K token trên model card là năng lực của Granite 4.2, không phải mức laptop 8GB đáp ứng nổi. Bộ đệm KV lưu khóa và giá trị của mọi token đã đọc, kích thước tính được từ cấu hình IBM Granite công bố: bản 3B có 40 lớp, 8 đầu KV, mỗi đầu 64 chiều, nên ở độ chính xác 16 bit mỗi token tốn 81.920 byte. Bản 8B dùng đầu 128 chiều nên tốn gấp đôi. Bảng dưới là phép tính theo công thức đó, cộng thêm tệp Q4_K_M 2,24 GB của mô hình 3B.
| Độ dài ngữ cảnh (token) | Bộ đệm KV bản 3B (GB) | Bộ đệm KV bản 8B (GB) | Tổng 3B Q4_K_M và KV (GB) |
|---|---|---|---|
| 4.096 | 0,34 | 0,67 | 2,58 |
| 8.192 | 0,67 | 1,34 | 2,91 |
| 16.384 | 1,34 | 2,68 | 3,58 |
| 32.768 | 2,68 | 5,37 | 4,92 |
| 131.072 | 10,74 | 21,47 | 12,98 |
Phép tính chưa gồm bộ đệm tính toán trung gian và phần nhân của phần mềm chạy mô hình, nên mức chiếm dụng thực tế cao hơn đôi chút. Ở 131.072 token, riêng bộ đệm KV của bản 3B đã vượt 10 GB, tức laptop 8GB không thể kích hoạt trọn ngữ cảnh. Ngưỡng hợp lý nằm quanh 8.192 đến 16.384 token, đủ cho tóm tắt một báo cáo vừa phải hay trao đổi nhiều lượt. Nén bộ đệm KV đang là hướng nhiều phòng nghiên cứu theo đuổi, bài DeepSeek giảm 90% KV cache ở 1 triệu token: lợi và hại là gì? phân tích cái giá phải trả khi cắt giảm bộ đệm này.
Hai thiết lập giúp kéo dung lượng xuống. Ollama mặc định ngữ cảnh 4.096 token và cho đổi qua biến OLLAMA_CONTEXT_LENGTH hoặc lệnh /set parameter num_ctx. Biến OLLAMA_KV_CACHE_TYPE=q8_0 giảm bộ đệm KV còn khoảng một nửa so với f16 khi Flash Attention hoạt động, theo tài liệu Ollama sai số thường không đáng kể. Trên laptop dùng GPU tích hợp, phần RAM cấp cho đồ họa cũng trừ vào cùng quỹ bộ nhớ, cơ chế được giải thích trong bài Bộ nhớ thống nhất trên laptop - Giới hạn của RAM 16 GB khi GPU dùng chung.
Ba chế độ suy nghĩ quyết định lượng token và thời gian chờ
Granite 4.2 bật chế độ thinking theo mặc định, mô hình viết chuỗi lập luận trong khối think rồi mới đưa đáp án. Chế độ non-thinking bỏ qua bước này, còn low-effort vẫn suy nghĩ nhưng rút ngắn chuỗi lập luận cho câu hỏi đơn giản. IBM khuyến nghị giới hạn 8.192 token sinh ra ở chế độ thinking và 2.048 token ở chế độ không suy nghĩ, mức chênh lệch gấp bốn lần phản ánh chi phí của bước lập luận.
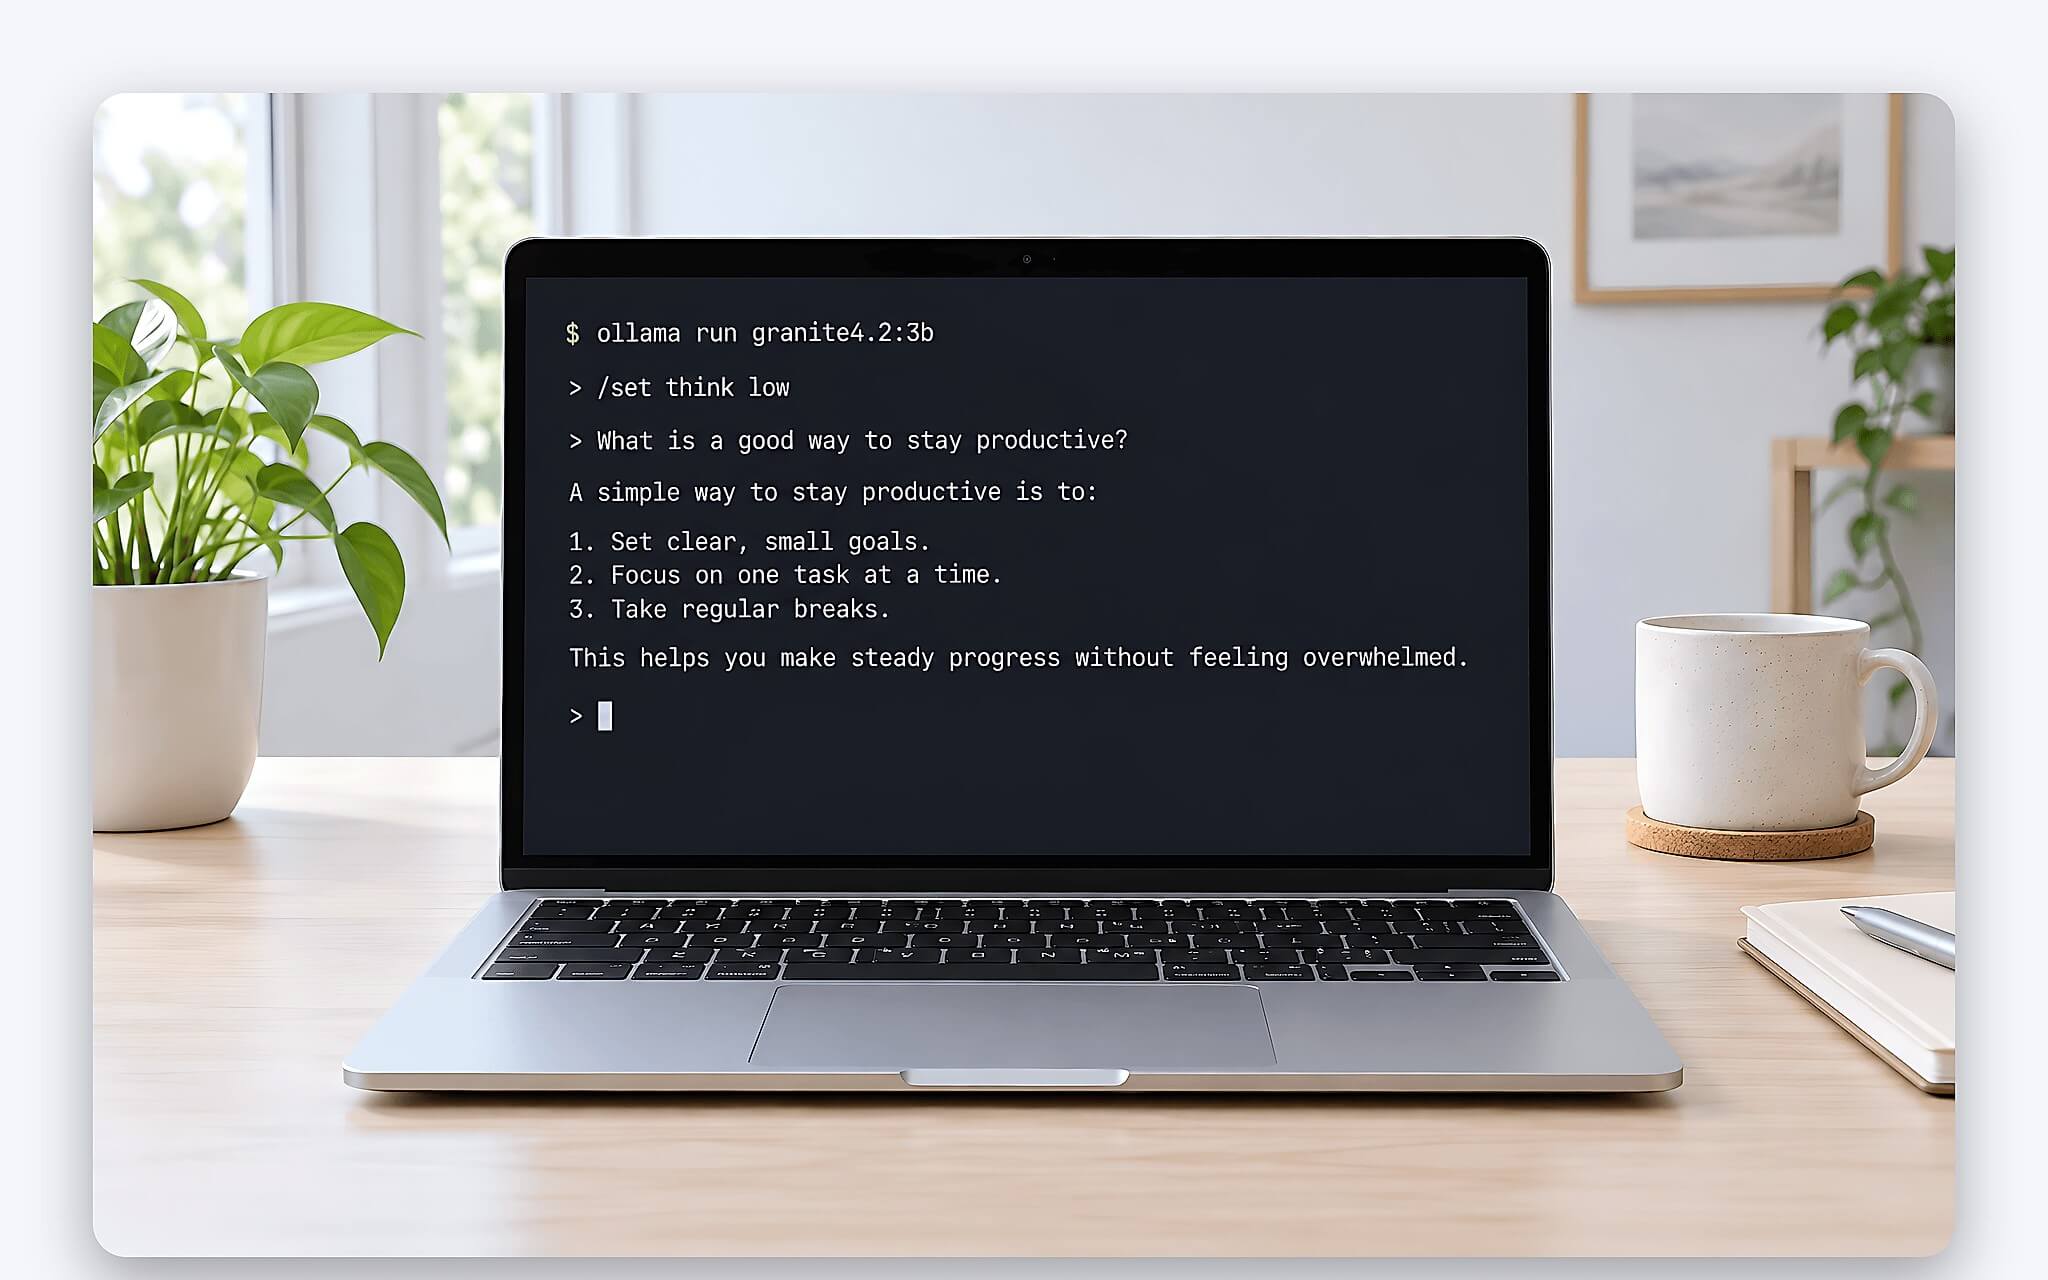
Trên cấu hình 8GB chạy bằng CPU, mỗi token sinh thêm đều tốn thời gian, nên chế độ suy nghĩ đầy đủ của mô hình 3B khiến thời gian chờ kéo dài rõ rệt với yêu cầu đơn giản như dịch một đoạn email hay đổi định dạng bảng. Trong Ollama, lệnh /set nothink tắt hẳn suy nghĩ, /set think low bật mức nhẹ, còn /set think high trả về mức sâu nhất. Qua API, tham số think trong options nhận các giá trị tương tự, thuận tiện khi tích hợp vào công cụ tự động hóa văn phòng.
Chuỗi suy nghĩ cũng chiếm ngữ cảnh. Mẫu hội thoại của IBM Granite mặc định cắt bỏ phần think của các lượt trước, tham số truncate_history_thinking giữ giá trị true, nhờ vậy lập luận cũ không lấp đầy hội thoại dài. Với mô hình 3B trên quỹ RAM hạn chế, cách phối hợp tối ưu là để non-thinking cho tác vụ soạn thảo, low-effort cho tra cứu nhanh và chỉ bật thinking đầy đủ khi giải bài toán nhiều bước hoặc rà lỗi logic trong mã nguồn.
Điểm chuẩn IBM công bố cho bản 3B so với 8B và 30B
Bảng đánh giá của Granite 4.2 trong model card dùng khung NeMo Evaluator SDK, mọi điểm dưới đây chép nguyên từ nguồn IBM Granite. Bản 3B đạt 78,33 điểm AIME25 về toán thi đấu và 69,71 điểm LiveCodeBench v6 về lập trình, khoảng cách tới bản 8B lần lượt 8,34 và 3,53 điểm. Khoảng cách lớn hơn xuất hiện ở bài đối thoại Arena-Hard-V2, nơi bản 3B đạt 34,96 so với 65,19 của bản 8B.
| Bài đánh giá (điểm) | Bản 3B | Bản 8B | Bản 30B |
|---|---|---|---|
| AIME25 | 78,33 | 86,67 | 89,17 |
| GPQA | 54,80 | 64,14 | 66,41 |
| LiveCodeBench v6 | 69,71 | 73,24 | 75,77 |
| MMLU-Pro | 67,84 | 74,04 | 77,60 |
| IFBench (prompt) | 74,33 | 79,33 | 77,17 |
| BFCL v4 | 52,41 | 52,39 | 61,39 |
| RULER 128K | 55,30 | 71,41 | 81,38 |
Kết quả BFCL v4 về gọi hàm cho thấy ưu thế bất ngờ: bản 3B đạt 52,41, nhỉnh hơn mức 52,39 của bản 8B, nghĩa là với tác vụ chọn công cụ và điền tham số, mô hình 3B gần như ngang cỡ lớn hơn. IFBench về tuân thủ chỉ dẫn cũng chỉ cách 5 điểm. Bản 3B không trải qua giai đoạn học tăng cường dạng agent như 8B và 30B, nên IBM Granite không công bố điểm SWE-bench hay Terminal-Bench cho cỡ này.
Điểm yếu lộ rõ ở ngữ cảnh dài và đa ngôn ngữ. RULER 128K của mô hình 3B chỉ đạt 55,30 so với 71,41 của bản 8B, còn MMLU-ProX lite do IBM đo đạt 27,78 so với 61,06. Hai con số này bổ sung lý do không nên kéo ngữ cảnh quá dài trên laptop 8GB, đồng thời nhắc rằng chất lượng tiếng Việt cần tự kiểm, vì tiếng Việt không nằm trong 12 ngôn ngữ IBM đã thử nghiệm đầy đủ.
Nạp mô hình lên laptop 8GB qua Ollama hoặc tệp GGUF
Cách nhanh nhất để chạy Granite 4.2 là lệnh ollama run granite4.2:3b, Ollama tự tải bản Q4_K_M 2,2 GB và mở phiên trò chuyện ngay trong terminal. Trang thẻ granite4.2:3b trên thư viện Ollama liệt kê đủ các biến thể từ q2_K tới bf16 cùng mức ngữ cảnh 128K, kèm thông số mặc định temperature 1 và top_p 0,95 theo khuyến nghị của IBM. Muốn đổi mức lượng tử, chỉ cần thay đuôi thẻ, ví dụ granite4.2:3b-q5_K_M.
Các công cụ đọc GGUF như llama.cpp hay LM Studio lấy tệp trực tiếp từ kho ibm-granite/granite-4.2-3b-GGUF của IBM Granite. Với llama.cpp, lệnh llama-server -hf ibm-granite/granite-4.2-3b-GGUF:Q4_K_M -c 8192 tải đúng mức Q4_K_M và đặt ngữ cảnh 8.192 token, đồng thời mở giao diện web cùng điểm cuối tương thích OpenAI. Cách này phù hợp khi cần khóa phiên bản tệp cố định hoặc chạy trên laptop không cài Ollama.
Để duy trì hiệu năng ổn định trên laptop 8GB, quy trình nên theo thứ tự: đóng trình duyệt nhiều thẻ, giữ ngữ cảnh 8.192 token, bật bộ đệm KV q8_0 và chọn chế độ suy nghĩ theo độ khó câu hỏi. Khi nhu cầu vượt quá mô hình 3B, ví dụ đọc hợp đồng dài hàng trăm trang hay cần điểm RULER cao hơn, nâng RAM lên 16GB để chạy bản 8B Q4_K_M 5,35 GB là phương án hợp lý hơn so với ép Granite 4.2 bản 3B mở ngữ cảnh lớn.
Câu hỏi thường gặp về Granite 4.2
Granite 4.2 có chạy trên laptop 8GB RAM không?
Có, với bản 3B ở mức Q4_K_M. Tệp nặng 2,24 GB, cộng bộ đệm KV khoảng 0,67 GB ở 8.192 token theo phép tính từ cấu hình model card, tổng chưa tới 3 GB trước phần nhân phần mềm. Bản 8B Q4_K_M 5,35 GB cộng ngữ cảnh sẽ đẩy laptop 8GB vào tình trạng dùng bộ nhớ ảo trên SSD, tốc độ suy giảm đáng kể.
Granite 4.2 khác gì Granite 4.0 về kiến trúc?
Granite 4.0 có các bản H lai Mamba-2 với attention, còn thế hệ 4.2 là Transformer dense hoàn toàn, hậu huấn luyện từ nền Granite 4.1 và bổ sung suy nghĩ tích hợp, ba chế độ suy nghĩ cùng gọi hàm có lập luận. Kiến trúc dense khiến bộ đệm KV tăng theo mọi lớp, nên độ dài ngữ cảnh cần tiết chế hơn trên laptop ít RAM.
Mô hình 3B có hỗ trợ tiếng Việt không?
Model card liệt kê 12 ngôn ngữ đã thử nghiệm gồm tiếng Anh, Đức, Tây Ban Nha, Pháp, Nhật, Bồ Đào Nha, Ả Rập, Séc, Ý, Hàn, Hà Lan và Trung, không có tiếng Việt. IBM ghi chú ngôn ngữ khác có thể hoạt động nhưng chưa được kiểm thử đầy đủ, nên câu trả lời tiếng Việt cần rà lại trước khi đưa vào tài liệu chính thức.
Giấy phép của IBM Granite có cho phép khai thác thương mại không?
Có. Toàn bộ dòng Granite 4.2 phát hành theo Apache 2.0, cho phép tích hợp vào sản phẩm thương mại, sửa đổi và phân phối lại, miễn giữ thông báo bản quyền và nội dung giấy phép theo điều khoản Apache.
0 phản hồi cho “Granite 4.2 trên laptop 8GB RAM - Chọn bản 3B và mức lượng tử hợp lý”