
Sáu GPU GeForce RTX 50 Laptop, từ RTX 5050 tới RTX 5090, đều dùng Tensor Core thế hệ thứ năm, khối phần cứng chuyên tính ma trận cho trí tuệ nhân tạo trong kiến trúc Blackwell. NVIDIA công bố nhóm GPU này đạt 440 đến 1.824 AI TOPS, tức số nghìn tỷ phép tính AI mỗi giây. Con số đó tính trên định dạng FP4 có 4 bit, còn RTX 40 Laptop chỉ hỗ trợ tới FP8, nên so trực tiếp dễ gây hiểu lầm. Phần dưới tách từng việc khối này đảm nhận, từ tạo ảnh, DLSS tới mức điện của laptop.
Tensor Core thế hệ 5 bổ sung định dạng FP4 và FP6
Tensor Core là khối chuyên thực hiện phép nhân và cộng ma trận, dạng tính toán chiếm phần lớn khối lượng xử lý trong mạng nơ-ron. Theo tài liệu kiến trúc RTX Blackwell của NVIDIA, thế hệ thứ năm vẫn hỗ trợ các định dạng FP16, BF16, TF32, INT8 và FP8 của đời trước, đồng thời bổ sung FP4 và FP6. Bảng so sánh laptop trên trang NVIDIA ghi Tensor Core thế hệ 2 trên RTX 20, thế hệ 3 trên RTX 30, thế hệ 4 trên RTX 40 và thế hệ 5 trên RTX 50. Sáu GPU RTX 50 Laptop cùng dùng thế hệ này.
Số bit càng ít thì mỗi trọng số mô hình chiếm càng ít bộ nhớ, và mỗi chu kỳ xử lý được nhiều phép tính hơn. Một giá trị FP16 dùng 16 bit, FP8 dùng 8 bit, còn định dạng FP4 chỉ dùng 4 bit. NVIDIA mô tả FP4 như một kiểu nén mô hình và cho biết, so với FP16, mô hình FP4 cần chưa tới một nửa bộ nhớ. Hãng cũng ghi thông lượng FP4 trên thế hệ Blackwell gấp đôi FP8. Mức gấp đôi là thông lượng lý thuyết, chỉ đạt khi phần mềm tận dụng đúng định dạng FP4.
Đổi sang 4 bit có cái giá là độ chính xác số học. Theo NVIDIA, FP4 gần như không làm giảm chất lượng nếu mô hình được lượng tử hóa bằng TensorRT Model Optimizer, tức cần một bước chuyển đổi riêng. Mô hình FP16 chưa chuyển vẫn chạy ở FP16 trên RTX 50. Intel cũng đặt khối nhân ma trận riêng trong GPU Arc, cách tổ chức và phần mềm gọi khối đó được phân tích ở bài Xe Matrix Engine là gì - Lõi XMX tăng tốc AI nhưng chưa chắc tăng FPS, hữu ích khi cần đặt hai hướng thiết kế cạnh nhau.
Vì sao AI TOPS của RTX 50 không so thẳng với RTX 40
AI TOPS là cách NVIDIA quy đổi sức tính của Tensor Core thành một con số in trên trang thông số. Theo bảng chính thức, RTX 5090 Laptop đạt 1.824 AI TOPS, gấp khoảng 2,7 lần mức 686 của RTX 4090 Laptop. RTX 5060 Laptop đạt 572, còn RTX 4060 Laptop đạt 233, chênh lệch khoảng 2,5 lần. Nhìn qua, khoảng cách giữa hai thế hệ rất lớn, trong khi số nhân CUDA của cặp RTX 4090 và RTX 5090 Laptop chỉ tăng từ 9.728 lên 10.496.
| GPU laptop | Thế hệ Tensor Core | Định dạng nhỏ được hỗ trợ | AI TOPS NVIDIA công bố |
|---|---|---|---|
| RTX 5090 Laptop | Thế hệ 5 | FP4 | 1.824 |
| RTX 4090 Laptop | Thế hệ 4 | FP8 | 686 |
| RTX 5080 Laptop | Thế hệ 5 | FP4 | 1.334 |
| RTX 4080 Laptop | Thế hệ 4 | FP8 | 542 |
| RTX 5070 Laptop | Thế hệ 5 | FP4 | 798 |
| RTX 4070 Laptop | Thế hệ 4 | FP8 | 321 |
| RTX 5060 Laptop | Thế hệ 5 | FP4 | 572 |
| RTX 4060 Laptop | Thế hệ 4 | FP8 | 233 |
| RTX 5050 Laptop | Thế hệ 5 | FP4 | 440 |
| RTX 4050 Laptop | Thế hệ 4 | FP8 | 194 |
Phụ lục của tài liệu kiến trúc NVIDIA RTX Blackwell giải thích chỗ khác biệt. Ở RTX 5090 bản desktop, dòng ghi FP4 AI TOPS là 1.676 khi tính dày và 3.352 khi kích hoạt tính năng sparsity, tức bỏ qua các trọng số bằng 0 theo cấu trúc định sẵn. RTX 4090 desktop không có FP4, định dạng nhỏ mà Tensor Core thế hệ 4 hỗ trợ là FP8, với 660,6 và 1.321,2 TOPS cho hai cách tính tương ứng. Thước đo này vì thế gắn với định dạng nhỏ mà từng thế hệ Tensor Core xử lý được.
Phép FP4 dùng nửa số bit của phép FP8, nên cùng một khối phần cứng cho con số lớn hơn khi đếm ở định dạng FP4. So AI TOPS giữa RTX 50 và RTX 40 Laptop vì vậy là so hai thước đo không cùng đơn vị nền. Phần mềm chỉ chạy FP16 hoặc FP8 sẽ nhận phần chênh lệch thấp hơn khoảng cách trên giấy. Khi cân nhắc giữa hai GPU tầm trung của hai thế hệ, bài Chơi game và làm AI: nên chọn RTX 5060 hay giữ RTX 4060 cho Laptop? phân tích riêng cặp này theo cả hiệu năng game lẫn tác vụ AI.
Định dạng FP4 thu nhỏ mô hình FLUX đến mức nào trên VRAM
Blog kỹ thuật của NVIDIA về TensorRT cho tạo ảnh FP4 trên RTX 50 đưa ra số đo cụ thể với mô hình tạo ảnh FLUX.1-dev của Black Forest Labs. Toàn bộ chuỗi xử lý gồm bộ mã hóa CLIP, bộ mã hóa văn bản T5, khối diffusion transformer và bộ giải mã VAE. Ở chế độ mặc định, bản FP16 cần 39,3 GB VRAM, bản FP8 cần 24,6 GB, còn bản dùng định dạng FP4 cần 21,67 GB. Khi bật chế độ tiết kiệm VRAM, ba mức lần lượt giảm còn 23,9 GB, 14,9 GB và 11,1 GB.
| Định dạng FLUX.1-dev | VRAM chế độ mặc định | VRAM chế độ tiết kiệm |
|---|---|---|
| FP16 | 39,3 GB | 23,9 GB |
| BF16 | 35,7 GB | 23,9 GB |
| FP8 | 24,6 GB | 14,9 GB |
| FP4 | 21,67 GB | 11,1 GB |
Mức giảm của toàn chuỗi không đạt một nửa, vì ngoài khối diffusion transformer nặng 23,8 GB ở FP16, chuỗi xử lý còn bộ mã hóa T5 nặng 9,52 GB cùng các thành phần nhỏ hơn. Tài liệu kiến trúc RTX Blackwell lại viết FLUX.dev ở FP16 cần hơn 23 GB VRAM, còn ở FP4 cần dưới 10 GB. Hai con số cùng của NVIDIA nhưng lệch nhau, nên khi tính VRAM cho laptop, mức 11,1 GB của toàn chuỗi khi bật chế độ tiết kiệm là căn cứ an toàn hơn mức dưới 10 GB.
Con số này gắn trực tiếp với cấu hình laptop. Theo NVIDIA, RTX 5050 và RTX 5060 Laptop có dung lượng 8 GB GDDR7, RTX 5070 Ti Laptop có 12 GB, RTX 5080 Laptop có 16 GB và RTX 5090 Laptop có 24 GB. Mức 11,1 GB vẫn vượt 8 GB, nên GPU 8 GB phải dùng mô hình nhỏ hơn hoặc chia tải sang RAM hệ thống. Về tốc độ, NVIDIA đo trên RTX 5090 bản desktop: 30 bước FLUX.1-dev mất 3.852,75 ms ở định dạng FP4 so với 6.680,93 ms ở FP8. GPU laptop chạy mức điện thấp hơn nên sẽ mất lâu hơn.
DLSS trên RTX 50 Laptop giao những việc nào cho Tensor Core
Trong game, Tensor Core gánh phần suy luận của DLSS. Theo tài liệu kiến trúc, DLSS 4 chuyển Super Resolution, Ray Reconstruction và DLAA sang mô hình transformer, loại mạng dùng cơ chế tự chú ý để nhận ra mối liên hệ giữa các vùng điểm ảnh cách xa nhau. Mô hình mới có số tham số gấp đôi mô hình CNN dùng từ thời DLSS 2 và cần nhiều sức tính của khối AI hơn để tái tạo hình ảnh. Super Resolution nhận khung hình độ phân giải thấp, kết hợp dữ liệu chuyển động rồi xuất ra khung hình độ phân giải cao.
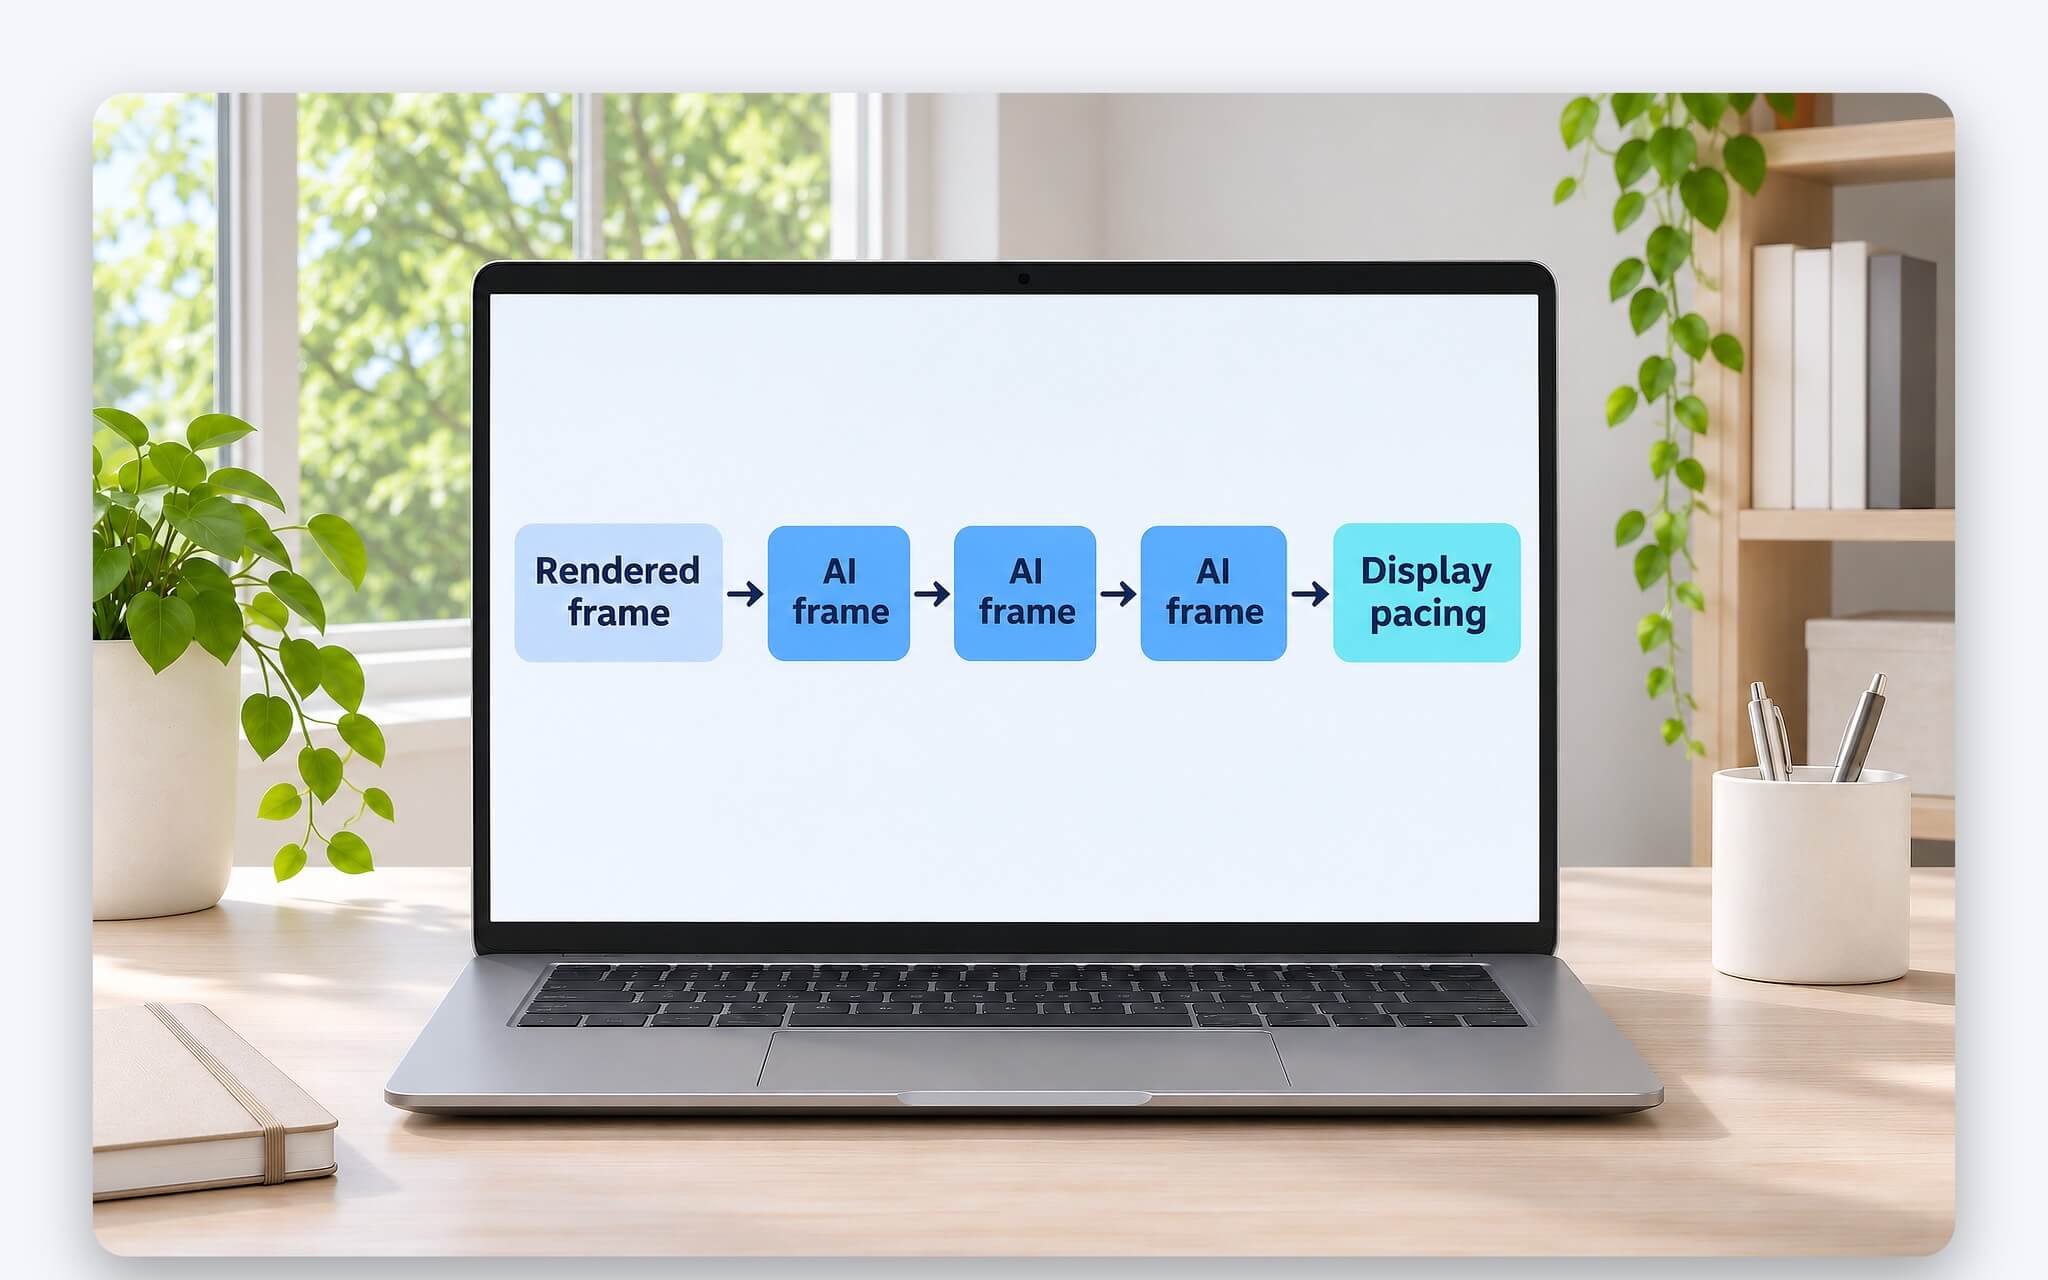
Phần tạo khung hình cũng dựa vào khối này. Ở DLSS 4, Multi Frame Generation tạo tối đa ba khung hình bổ sung cho mỗi khung hình kết xuất thông thường. NVIDIA cho biết mô hình tạo khung hình mới nhanh hơn 40% so với cách làm cũ, dùng ít hơn 30% VRAM và chỉ cần chạy một lần cho mỗi khung hình kết xuất. Trường quang lưu, tức dữ liệu mô tả hướng di chuyển của từng điểm ảnh, trước đây tính bằng phần cứng riêng, nay được thay bằng một mô hình AI chạy trên Tensor Core thế hệ 5.
Trang RTX 50 Laptop hiện tại của NVIDIA ghi thêm Dynamic Multi Frame Generation, tạo tới năm khung hình cho mỗi khung hình kết xuất, cùng DLSS 5 với 3D-Guided Neural Rendering dành cho GPU RTX 50. Việc chia nhịp hiển thị các khung hình tạo thêm do Flip Metering trong bộ hiển thị đảm nhận, thay cho cách điều nhịp bằng CPU ở DLSS 3 vốn dễ lệch nhịp khi số khung tăng. Khung hình tạo thêm làm chuyển động mượt hơn, còn độ trễ thao tác vẫn gắn với khung hình kết xuất gốc.
Bộ xếp lịch AMP cho tác vụ AI chạy song song đồ họa
Một laptop RTX 50 có thể vừa chạy game với DLSS vừa lọc tiếng ồn micro bằng NVIDIA Broadcast. Để tác vụ AI và đồ họa dùng chung GPU, Blackwell có AI Management Processor, viết tắt AMP, là một bộ xử lý RISC-V riêng đặt ở đầu đường ống GPU. AMP nhận việc xếp lịch các ngữ cảnh GPU thay cho CPU, theo mô hình Hardware-Accelerated GPU Scheduling mà Microsoft đưa vào Windows 10 từ bản cập nhật tháng 5 năm 2020.
| Tác vụ trên laptop RTX 50 | Khối phần cứng xử lý chính | Ghi chú theo NVIDIA |
|---|---|---|
| DLSS Super Resolution, Ray Reconstruction | Tensor Core thế hệ 5 | Mô hình transformer, số tham số gấp đôi mô hình CNN |
| Multi Frame Generation | Khối AI và Flip Metering | Bộ hiển thị điều nhịp khung hình thay CPU |
| Xếp lịch AI và đồ họa | AMP | Bộ xử lý RISC-V ở đầu đường ống GPU |
| Dò tia trong game | RT Core thế hệ 4 | Tách khỏi phần suy luận AI |
| Ghi hình, mã hóa AV1 | NVENC thế hệ 9 | 3 bộ trên RTX 5090 Laptop, 2 bộ trên RTX 5080 Laptop |
| Giải mã video | NVDEC thế hệ 6 | 2 bộ trên RTX 5090 và RTX 5080 Laptop |
Tài liệu kiến trúc nêu ví dụ các mô hình NVIDIA ACE gồm giọng nói, dịch thuật, thị giác, hoạt ảnh và hành vi chạy đồng thời với trợ lý G-Assist cùng tác vụ đồ họa. Khi GPU tự quản hàng đợi, số lượt trao đổi với CPU giảm, nhịp khung hình đều hơn và Windows đa nhiệm nhẹ hơn. Với DLSS 4, AMP còn điều phối giữa phần suy luận AI, phần kết xuất và thuật toán chia nhịp khung hình.
Ngoài game, trang RTX 50 Laptop của NVIDIA nhắc tới việc chạy mô hình ngôn ngữ cục bộ qua LM Studio, AnythingLLM và các quy trình tạo ảnh đã tối ưu trong ComfyUI. Mã hóa video không thuộc phần việc của khối AI mà do bộ NVENC thế hệ 9 đảm nhận, trong đó RTX 5090 Laptop có 3 bộ, RTX 5080 Laptop có 2 bộ và các GPU còn lại có 1 bộ. Khi vừa ghi hình vừa lọc nền, các khối chuyên biệt chia nhau tải.
Mức điện và xung nhịp quyết định AI TOPS thực nhận trên laptop
Phụ lục tài liệu kiến trúc ghi rõ các mức TOPS đỉnh được tính theo xung nhịp Boost của GPU. Trên laptop, xung Boost lại trải theo dải điện năng do hãng sản xuất laptop cấu hình. NVIDIA công bố dải điện năng GPU của RTX 5090 Laptop là 95 đến 150 W, RTX 5080 Laptop 80 đến 150 W, RTX 5070 Ti Laptop 60 đến 115 W, RTX 5070 Laptop 50 đến 100 W, RTX 5060 Laptop 45 đến 100 W và RTX 5050 Laptop 35 đến 100 W.
Cùng một GPU, bản cấu hình mức điện thấp sẽ duy trì xung nhịp thấp hơn, nên AI TOPS thực nhận không chạm con số in trên trang thông số. Dải xung Boost của RTX 5060 Laptop là 1.455 đến 2.497 MHz, còn RTX 5070 Ti Laptop là 1.447 đến 2.220 MHz. Thời gian tạo ảnh hay xử lý video bằng AI trên hai laptop dùng cùng RTX 5070 Ti có thể chênh nhau đáng kể nếu mức điện khác nhau. Hệ tản nhiệt quyết định laptop có duy trì được mức điện đó trong phiên dài hay phải hạ xung giữa chừng.
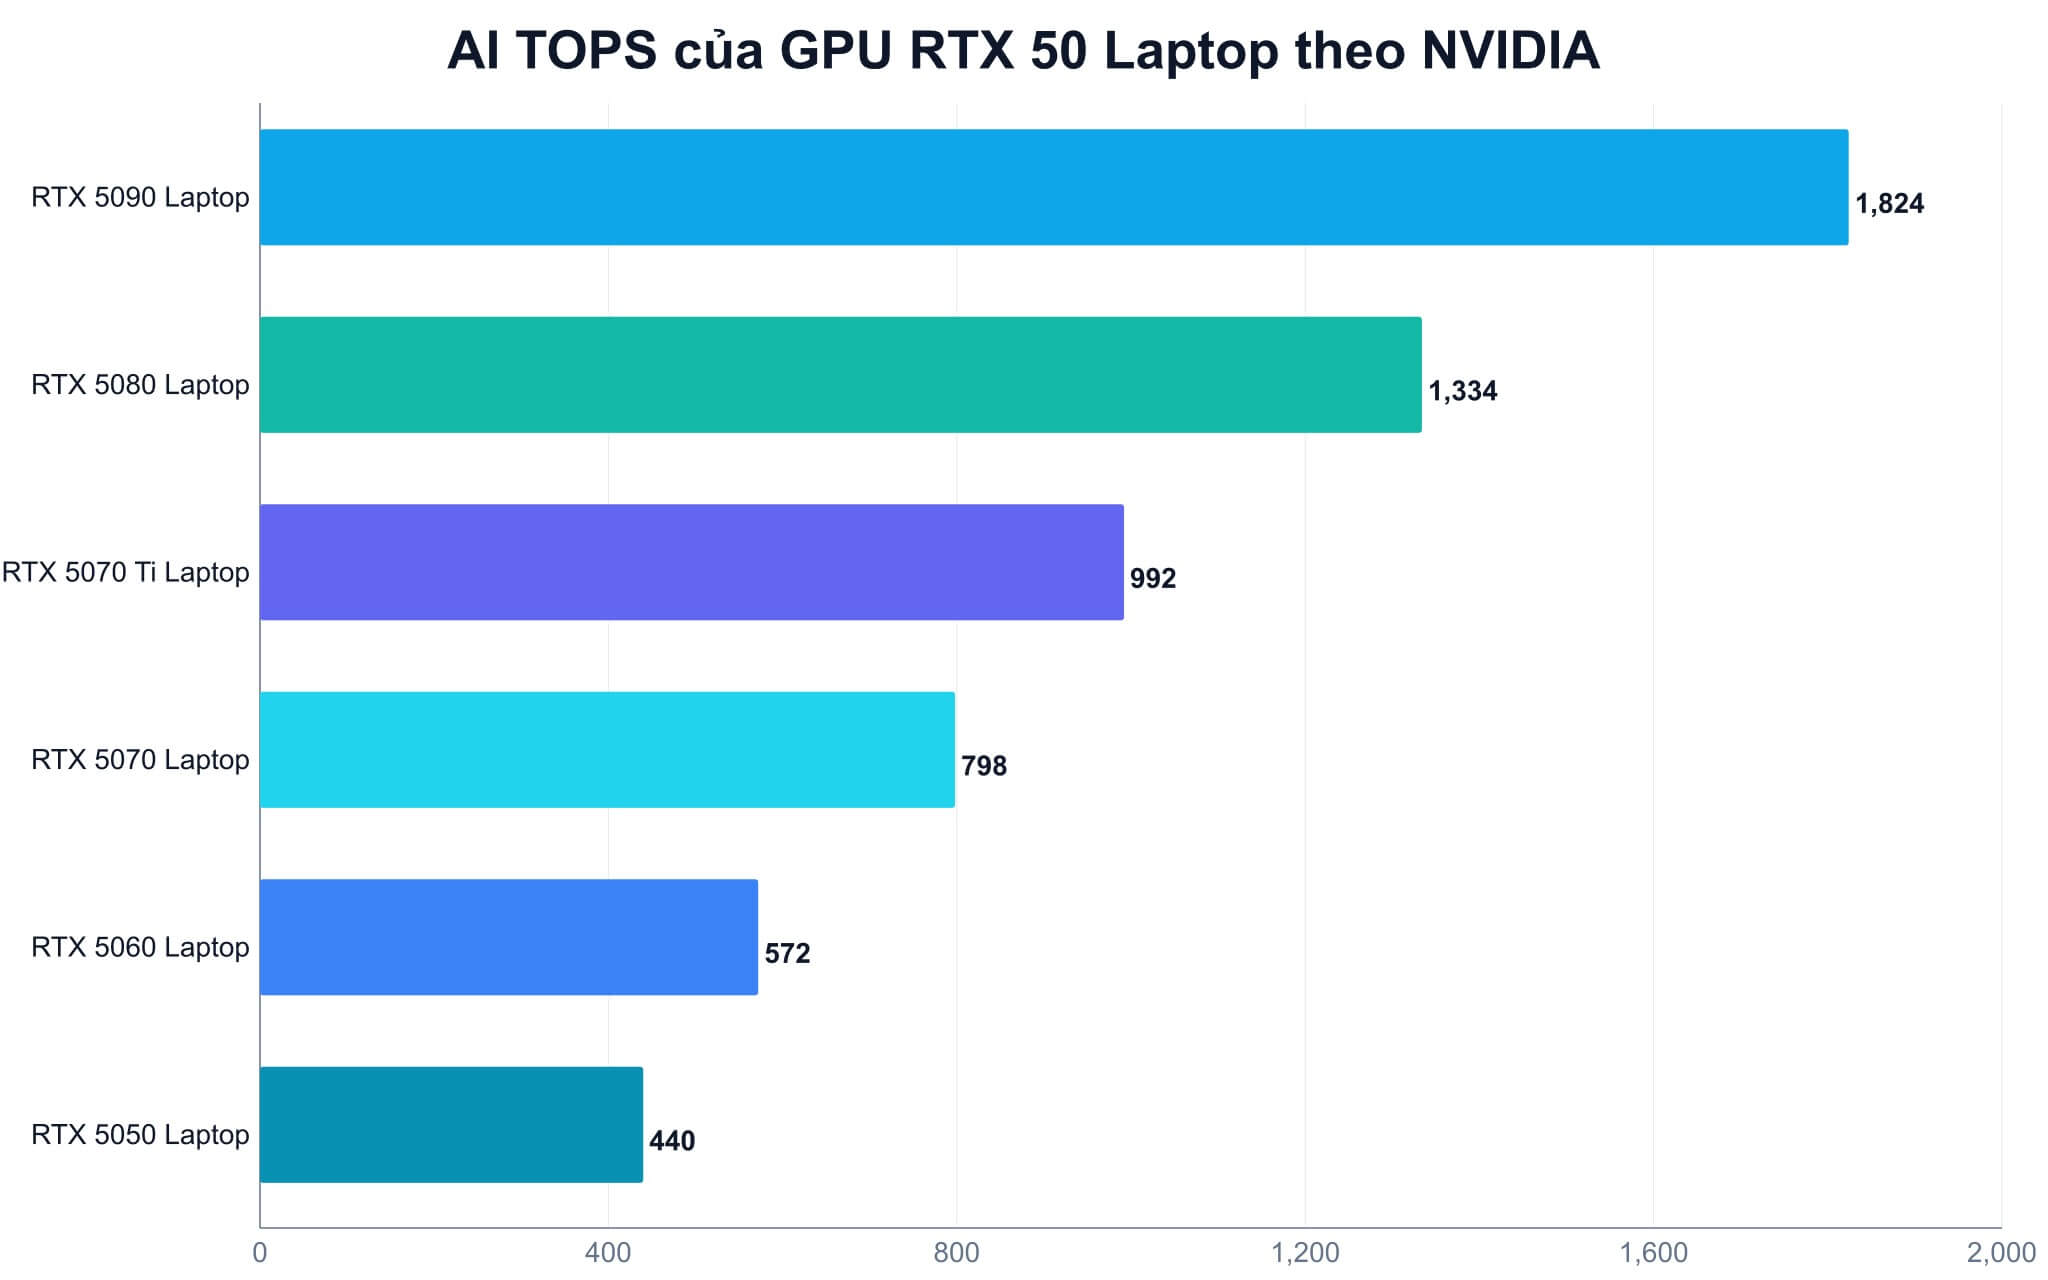
Quy mô chip cũng chênh lệch rõ giữa sáu GPU. AI TOPS lần lượt là 1.824, 1.334, 992, 798, 572 và 440 từ RTX 5090 Laptop xuống RTX 5050 Laptop, đi cùng 10.496, 7.680, 5.888, 4.608, 3.328 và 2.560 nhân CUDA. Băng thông bộ nhớ theo NVIDIA là 896 GB/s ở RTX 5090 và RTX 5080 Laptop, 672 GB/s ở RTX 5070 Ti Laptop và 384 GB/s ở ba GPU còn lại. Với tác vụ phải nạp trọng số liên tục, dung lượng VRAM và băng thông quyết định kết quả nhiều hơn con số TOPS.
Câu hỏi thường gặp (FAQ)
Tensor Core trên RTX 5050 Laptop có khác RTX 5090 Laptop không?
Hai GPU cùng dùng khối AI thế hệ 5, cùng hỗ trợ FP4, FP6 và DLSS Multi Frame Generation. Khác biệt nằm ở quy mô: RTX 5050 Laptop đạt 440 AI TOPS với 2.560 nhân CUDA và 8 GB GDDR7, còn RTX 5090 Laptop đạt 1.824 với 10.496 nhân CUDA và 24 GB GDDR7.
Mô hình FP16 có tự chạy bằng FP4 khi cài lên laptop RTX 50 không?
Không. Mô hình phải được lượng tử hóa sang định dạng FP4, NVIDIA giới thiệu công cụ TensorRT Model Optimizer cho bước này. Mô hình chưa chuyển vẫn chạy ở định dạng gốc như FP16 hoặc FP8, nên ưu thế về bộ nhớ và thông lượng của FP4 chưa xuất hiện.
GPU 8 GB có chạy trọn FLUX.1-dev bản FP4 trong VRAM không?
Theo blog TensorRT của NVIDIA, toàn chuỗi FLUX.1-dev ở FP4 cần 11,1 GB khi bật chế độ tiết kiệm VRAM, vượt mức 8 GB của RTX 5050 và RTX 5060 Laptop. Tài liệu kiến trúc ghi mức dưới 10 GB, cũng vẫn vượt 8 GB, nên cần ưu tiên mô hình nhỏ hơn hoặc chia tải sang RAM.
RTX 40 Laptop có hỗ trợ Multi Frame Generation không?
Bảng so sánh laptop của NVIDIA ghi RTX 40 Laptop có DLSS Frame Generation, Super Resolution và Ray Reconstruction, còn Dynamic Multi Frame Generation chỉ có trên RTX 50. Tài liệu kiến trúc cho biết tính năng này dựa vào Tensor Core thế hệ 5, AMP và Flip Metering của Blackwell.
0 phản hồi cho “Tensor Core trên laptop RTX 50 - FP4, AI TOPS và DLSS làm được những gì”